Вступ
В одному з минулих матеріалів, коли ми препарували майнерські прискорювачі P104-100, я побіжно згадував, що попри свій поважний вік архітектура Pascal все ще непогано порається з генерацією зображень. І, відверто кажучи, на цьому можна було б поставити крапку, змирившись з тим, що старенькі GTX 1070/1080/1080Ti, P104-100 чи P102-100 просто доживають свій вік. Проте, як завжди, є одне суттєве «але»: дивлячись на те, як ці карти пихтять у stable-diffusion.cpp на сучасних важких моделях рівня Krea 2 або Z-Image, мене не полишало відчуття, що софт використовує лише третину реального потенціалу кремнію.
Невеличкий технічний екскурс, щоб ми з вами були на одній хвилі. Чому взагалі відеокарти сімейства Pascal (серія GTX 1000 та їхні «безголові» майнерські брати P104/P102) так сильно страждають у сучасних нейромережах? Все впирається у два жорстких апаратних обмеження:
Повна відсутність тензорних ядер (Tensor Cores). Вони з'явилися лише в наступному поколінні (Volta / Turing).
Катастрофічно урізаний блок FP16. На споживчих GPU, заснованих на архітектурі Pascal (у термінології CUDA це рівень можливостей SM 6.1 - кристали GP102, GP104, GP106 та GP107), продуктивність у половинній точності (
FP16/half2) штучно задушена у 64 рази відносно стандартногоFP32(так званий штраф 1:64).
Тобто будь-який сучасний код, який на умовній RTX 2060 Super чи RTX 3090 отримує двократне прискорення за рахунок переходу з FP32 на FP16, на картах GTX 1000 або взагалі не працює, або перетворює відеокарту на слайд-шоу.
Але що ми ще знаємо про GPU на архітектурі Pascal (за винятком хіба що офісної GT 1030 на чипі GP108)? Правильно - саме в чипах SM 6.1 інженери NVIDIA додали дуже цікаву, але часто ігноровану розробниками апаратну інструкцію __dp4a (Dot Product of 4x 8-bit Integers and Accumulate). Якщо казати максимально просто: замість того, щоб рахувати важкі 32-бітні числа з плаваючою комою по одному за такт, відеокарта бере одразу чотири 8-бітних цілих числа (INT8), перемножує їх з іншою четвіркою і складає результат у 32-бітний акумулятор. І все це — за один такт!
Давайте подивимось на сухі цифри на прикладі народної GTX 1070:
У класичному режимі
FP32її стеля - близько 6.5 TFLOPS.А от у режимі
INT8 __dp4aтеоретичний пік злітає до ~26 TOPS. Тобто фізично кристал здатен перемолоти у 4 рази більше математичних операцій за ту саму одиницю часу!
Тому ідея напрошувалась сама собою: а що як змусити stable-diffusion.cpp рахувати важкі дифузійні моделі (Anima, Krea 2, Z-Image) через швидкий нативний INT8 __dp4a, не втративши при цьому якість картинки і не вилетівши за межі 8 ГБ відеопам'яті?
Як це все відбувалося
Одразу буду з вами максимально чесним: я залізячник та оверклокер, і хоча я чудово розумію саму архітектуру чипів, роботу пам'яті та логіку конвеєра, написати з нуля низькорівневі матричні ядра на C++/CUDA з інтринсіками, шаред-меморі та варп-редукціями - для мене завдання за межею реальності. Тому цей проєкт народжувався у специфічному тандемі.
Починалася вся ця епопея ще разом із Gemini 3.8 Flash, але, відверто кажучи, з нею ми швидко вперлися в стіну: "старенька" періодично ліпила дитячі помилки в коді та вперто сперечалася з моїми інженерними гіпотезами і взагалі, пушила тейк що з Паскалю вичавили вже все що можливо. Але, моя чуйка казала чітко: ГПУ валяться в фолбек на FP32 і не використовують свої м'язи на повну.
Справжній прорив стався тоді, коли ми переїхали на нову Gemini 4 Hydrogen (далі по тексту я буду називати її просто «Гідра», бо за ті десятки годин, що ми провели разом над цим кодом, вона вже стала як рідна). І ось тут робота пішла зовсім на іншому рівні: Гідра поводилася як дорослий системний інженер - вона без зайвих суперечок брала мої архітектурні ідеї, перекладала їх у чистий CUDA-код, одразу перевіряла на живому залізі, і лише у тих вкрай рідкісних випадках, коли мій задум об'єктивно не працював на рівні математики чи компілятора, аргументовано пропонувала обхідний шлях.
Чи було це просто? Звісно ж ні! Як з'ясувалося під час ревізії коду, просто взяти і «прикрутити __dp4a» до stable-diffusion.cpp не вийде - частково він там вже був, а спадок від перших спроб із 3.8 Flash приховував чимало сюрпризів. Тож нумо розбиратися, де саме ховалися гальма і як нам вдалося прискорити старий добрий Pascal майже вдвічі.
Трішки подробиць
Перше важливе відкриття, яке ми з Гідрою зафіксували ще на етапі розбору польотів: стоковий бекенд ggml-cuda вже вміє використовувати __dp4a на картах Pascal! Більше того, він робить це всередині свого стандартного квантованого ядра mmq (matrix multiplication quantized).
Здавалося б - розходимось, все вже написано до нас, так? А от і ні. Проблема стокового mmq у тому, що він оперує невеликими тайлами 64×64 і постійно витрачає ресурси чипа на розпаковку складних блоків квантування прямо під час множення матриць. У результаті на GTX 1070 стокове ядро видавало лише жалюгідні ~7.8 TOPS із теоретичних 26 TOPS пікової потужності. Тобто понад дві третини обчислювального потенціалу GPU простоювали через неоптимальну роботу з пам'яттю та регістрами. Саме тому наші перші наївні спроби «просто підсунути свій __dp4a» без повної переробки тайлінгу та кешування впиралися у стелю стокового коду або навіть програвали йому.
До того ж, коли ми оновили кодову базу stable-diffusion.cpp до актуального master (коміт b9d7176, підмодуль ggml d803c238) і Гідра провела повний аудит старого коду, який ми починали писати ще з Gemini 3.8 Flash, спливли три критичні проблеми:
Мертва перевірка архітектури. У старому коді перевірка покоління GPU виглядала як
cc == 61. Звучить логічно для SM 6.1? А от і ні: всерединіggml-cudaверсії архітектур множаться на сто, і для Pascal використовується константа610(GGML_CUDA_CC_DP4A). Через цей банальний недогляд кастомний шлях узагалі не вмикався на реальних картах GTX 1000.Помилки бітової розпаковки та розмірностей. У початкових функціях деквантування
Q4_KтаQ3_Kзнайшлися баги зі зсувами бітів, форматQ8_0був взагалі відсутній, а головне — код не перевіряв старші розмірності тензорів (ne2 / ne3) та їхню безперервність у пам'яті (contiguous). Як наслідок - при спробі порахувати багатовимірні батчі ядро могло читати сміття з пам'яті.Втрачений макрос при збірці. Система збірки CMake банально не передавала макрос
SD_USE_CUDAфінальним бінарникамsd-cli(і, як з'ясувалося пізніше,sd-server). Тобто ви могли скільки завгодно прописувати прапорець--dp4aу консолі, але сам виконуваний файл навіть не підозрював, що йому дозволено смикати CUDA-функції нашого бекенду.
Щоб раз і назавжди закрити питання сумісності та чистоти експерименту, ми зібрали єдиний уніфікований бінарник (sd-cli_DP4a.exe та sd-server_DP4a.exe через зв'язку portable-msvc + CUDA 12.9 + Ninja). Логіка максимально проста і прозора: за замовчуванням він працює як на 100% чистий сток, але варто додати прапорець --dp4a (або змінну середовища SD_CUDA_DP4A=1), як вмикається наш прискорений конвеєр. А от у серверній версії sd-server_DP4a.exe ми увімкнули --dp4a одразу за замовчуванням — щоб він безшовно підхоплював прискорення у нашій веб-оболонці CoT Studio без зайвих танців з бубном.
Як ми тестували
Хто читає мої матеріали давно, той знає: я терпіти не можу «тепличні» або маніпулятивні тести, коли в одному прогоні випадково вивантажився браузер, а в іншому модель полізла у повільну системну ОЗП через своп драйвера. Тому шоб виключити будь-які похибки на тестовому стенді з GTX 1070 8 ГБ (CUDA_VISIBLE_DEVICES=0), ми зафіксували жорсткий протокол тестування, однаковий як для стоку, так і для --dp4a:
Послідовне вивантаження модулів (
--offload-to-cpu --mmap) та текстовий енкодер на процесорі (--backend te=cpu). Навіщо це потрібно? Коли ви генеруєте картинку на 8 ГБ відеокарті, тримати в пам'яті одночасно важкий текстовий енкодер (наприклад, Qwen 3 VL або T5) і саму дифузійну модель - це гарантований виліт за межі VRAM. У нашому випадку процесор спокійно відпрацьовує текст (вхідний промпт), після чого під час самого семплінгу (Stage 2) у відеопам'яті GTX 1070 знаходиться виключно дифузійна модель.Обов'язковий FlashAttention (
--diffusion-fa) та тайлінг VAE (--vae-tiling --vae-tile-size 512x512). І ось тут показова історія про різницю підходів двох моделей. Ще на старті проєкту Gemini 3.8 Flash агресивно пушила ідею дрібного тайлінгу VAE64×64(мовляв, так безпечніше для відеопам'яті) і вперто сперечалася зі мною, коли я наполягав на512×512. Коли ж ми перейшли на Гідру, вона без жодних заперечень одразу протестувала мій варіант із тайлом512×512— і виявилося, що я мав рацію на всі сто: такий розмір чудово влазить у VRAM, дає адекватну швидкість декодування і не плодить зайвих швів на зображенні.Фіксований
--seed 42. Це база для прямого візуального порівняння. Ми звіряли кожну тестову генерацію буквально «піксель у піксель, деталь у деталь», щоб переконатися, що перехід на 8-бітну цілочисельну математику не перетворив картинку на мильне місиво.Роздільний замір часу. Ми окремо фіксували чистий час роботи самого семплера (
Stage 2, швидкість кроку вs/it) та загальний час генерації від моменту запуску до збереження PNG на диск.
Еволюція архітектури: 5 кроків до фінального результату
Коли ми вичистили старі баги і отримали стабільний тестовий стенд, постало головне інженерне питання: як саме побудувати обчислювальний конвеєр, щоб вичавити з GTX 1070 та P102 максимум тих самих 26 TOPS і при цьому не впертися в обсяг відеопам'яті? До фінальної архітектури ми йшли у п'ять ітерацій.
Крок 1. Великотайловий конвеєр W8A8 128×128 __dp4a GEMM (dp4a_gemm.cu)
Чому стокове ядро mmq так слабко навантажувало чип? Бо воно працює з дрібними тайлами 64×64 і намагається розпаковувати хитромудрі формати квантування ggml (де біти перемішані зі скейлами в блоках) прямо на льоту всередині матричного множення.
Ми пішли іншим шляхом і реалізували повноцінний матричний конвеєр W8A8 (де і ваги моделі, і активації приводяться до чистого 8-бітного формату int8):
Попередня перепаковка ваг. Квантовані шари моделі заздалегідь розпаковуються у максимально простий, «плаский» масив
int8із окремим рядковим коефіцієнтом масштабування (scale_B[N]). Жодних побітових зсувів під час самого множення!Швидке квантування активацій на льоту. Вхідні активації (які йдуть у
FP32) перед множенням миттєво квантуються уint8разом із власним скейлом (scale_A[M]) за допомогою широких векторних завантаженьfloat4(kernel_quant_row_f32_to_i8_vec4).Масивне ядро
128×128. Саме ядро множення матриць (kernel_w8a8_dp4a_128x128) рахує вже великий тайл128×128. Щоб ядра не голодували без даних, завантаження з внутрішньої Shared Memory чипа відбувається широкими 128-бітними транзакціямиLDS.128(типint4— одразу по 16 чиселint8за такт) із попередньою підкачкою в регістри (register prefetch). Після того як__dp4aблискавично перемножує цілі числа вint32акумулятор, результат просто домножується наscale_A * scale_Bі повертається у чеснийFP32.
Що це дало на практиці? Перший же замір на легкій тестовій моделі anima-Q4_K (512×768, 20 кроків) показав, що час семплінгу на GTX 1070 впав із стокових 49.24 с (2.41 с/it) до 37.15 с (1.78 с/it). Плюс 32.5% швидкості з першого ж заходу! Але це була лише розминка.
Крок 2. Нативний INT8 __dp4a FlashAttention (fattn_dp4a.cuh)
Коли ми прискорили звичайне множення матриць (MUL_MAT) і увімкнули внутрішній профайлер (SD_CUDA_PROF=1), картина змінилася: тепер головним гальмом став блок уваги - FLASH_ATTN_EXT, який з'їдав до 20–25% часу кожного кроку генерації. І це логічно: у стоковому ggml-cuda для архітектури Pascal просто немає швидкого спеціалізованого ядра FlashAttention, тому відеокарта змушена прокручувати важкі матриці уваги через повільні шляхи у FP32.
Ми з Гідрою вирішили не залишати це вузьке місце і написали власне ядро kernel_flash_attn_dp4a<D> (спочатку під стандартну розмірність голови уваги head_dim = 128, а згодом додали і підтримку head_dim = 64 із захистом меж пам'яті для потоків варпу lane >= 16):
Тайли матриць
Q,K,PтаVквантуються вINT8прямо на льоту всередині блоку.Найважчі матричні добутки
Q·KᵀтаP·Vтепер теж крутяться на максимальній швидкості через апаратний__dp4a.Критичний момент для Pascal -чесний
FP32онлайн-софтмакс. Проміжний розрахунок експоненти (softmax) між двома множеннями виконується суворо в 32-бітній точності (FP32). Ми свідомо не використали там жодної інструкціїhalf2(FP16), щоб випадково не спіймати той самий 64-кратний штраф швидкості на картах GTX 1000. Додатково в ядро заклали повноцінну підтримку GQA (Grouped-Query Attention) та масок уваги.
Результат перевершив очікування: сам оператор FLASH_ATTN_EXT прискорився у 2.12 раза! Загальний час семплінгу на моделі anima-Q4_K скоротився вже до 28.66 с (1.40 с/it, тобто +71.8% відносно стоку). А на версії anima-Q3_K ми отримали падіння часу з 52.49 с до 28.46 с (1.39 с/it) — приріст швидкості склав вражаючі +84.4%!
Крок 3. Дворівнева робота з пам'яттю: Persistent W8 Cache + Scratchpad Buffer
На відносно компактній моделі Anima все літало, але щойно ми перейшли до справді важких сучасних гігантів - таких як Krea 2 (~5.3 ГБ) та Z-Image (~5 ГБ) - на 8-гігабайтній GTX 1070 ми боляче вдарилися об стелю відеопам'яті.
Чому так сталося? Дивіться: щоб працювати без затримок, нашому ядру з Кроку 1 потрібно зберігати у VRAM розпаковану int8-копію ваг. Для невеликої моделі це не проблема. Але коли сама модель займає понад 5 ГБ, спроба покласти поруч ще й її розпакований кеш призводить або до миттєвого вильоту за нестачею пам'яті (Out of Memory), або до ще гіршого сценарію - внутрішній планувальник ggml_graph_cut бачить дефіцит VRAM, починає різати граф обчислень на десятки дрібних шматків і на кожному кроці ганяє шари туди-сюди через повільну шину PCIe.
Потрібно було елегантне інженерне рішення, яке б дозволило і рибку з'їсти (зберегти швидкість тайлів 128×128), і в ліміт 8 ГБ вписатися. Так народилася дворівнева схема пам'яті в dp4a_gemm.cu у парі з новими надшвидкими ядрами розпаковки (32×8, 8 варпів на блок):
Рівень 1 (
Persistent W8 Cache- постійний кеш у VRAM). Ядро кешує розпакованіint8-ваги шарів у відеопам'ять рівно доти, доки на карті залишається залізний безпечний резерв у1536 МБвільної пам'яті (перевіркаcudaMemGetInfo < need_bytes + 1536 МБавтоматично зупиняє подальше розростання кешу). Чому саме півтора гігабайта? Цього запасу гарантовано вистачає для робочих буферів графа та декодера VAE, завдяки чомуggmlніколи не ріже модель на сегменти.Рівень 2 (
On-the-fly Layer Scratchpad- тимчасовий буфер одного шару). Усі шари важкої моделі, які не помістилися в Рівень 1 (або взагалі всі шари, якщо примусово задатиSD_CUDA_DP4A_CACHE_MB=0), не відкочуються на повільний стоковийmmq! Замість цього прямо перед множенням матриць поточний шар за мікросекунди розпаковується у єдиний перевикористовуваний тимчасовий буфер розміром лише ~16–96 МБ (Scratchpad) і все одно пережовується нашим швидким ядром128×128 __dp4a.
Перевірка боєм: коли ми заради експерименту повністю вимкнули постійний кеш (CACHE_MB=0), залишивши лише крихітний 16-мегабайтний Scratchpad, модель anima-Q4_K видала 29.36 с (1.43 с/it) проти 28.66 с із повним кешем — втрата швидкості склала якісь копійчані 2%, зате економія VRAM колосальна! А головне - 5.5-гігабайтна Krea 2 Turbo Q3_K тепер спокійно помістилася у 8 ГБ пам'яті GTX 1070 і прискорилася зі стокових 50.17 с (6.03 с/it) до 28.59–28.67 с (3.25–3.32 с/it), давши чисті +75% приросту!
Крок 4. Підтримка всього зоопарку квантів та детектив із sd-server
Щоб наш бекенд був універсальним інструментом, а не милицею під один конкретний файл, ми з Гідрою послідовно написали швидкі ядра розпаковки (32×8) для всієї лінійки популярних форматів квантування ggml:Q3_K, Q4_K, Q4_0, Q4_1, Q5_K, Q5_0, Q5_1, Q6_K та Q8_0.(Невеличка ремарка для допитливих: формату Q6_1 у природі ggml просто не існує, бо 6-бітні ваги там представлені виключно блоками Q6_K, а специфічне сімейство векторних квантів IQ* ми свідомо залишили за дужками).
Коли ж прийшов час інтегрувати наше рішення у sd-server для роботи всередині моєї локальної студії CoT Studio, виліз дуже підступний баг. Запускаю генерацію важкої моделі сімейства Z-Image (Q5_K) у розширенні 832×1216 через студію - і бачу жахливі 11 с/it. Тобто швидкість рівня чистого стоку! Як так, якщо в консольному sd-cli все літає?
Розтин показав класичну пастку системи збірки: у CMakeLists.txt прапорець компіляції SD_USE_CUDA передавався лише консольному клієнту, а серверний таргет sd-server збирався без нього і мовчки ігнорував наш бекенд. Після того як ми виправили CMake та перезібрали sd-server_DP4a.exe, час кроку на Z-Image безпосередньо в інтерфейсі CoT Studio миттєво впав із 11 с до 6.9 с (навіть із текстовим енкодером на GPU), а в чистому CLI-режимі - взагалі до 5.43 с/it!
Крок 5. Ізоляція кешу для сервера та захист VAE від пастки FP16 1:64
На фінальному етапі полірування ми закрили ще два критично важливих інженерних моменти, без яких бекенд не можна було б назвати стабільним:
Безпечне очищення кешу при зміні моделі в
sd-server(g_state[device]). У чому тут підступ? Консольнийsd-cliзапустився, згенерував картинку і закрився - операційна система сама прибрала всю пам'ять. А отsd-serverвисить у фоні постійно. Наш кеш першого рівня запам'ятовує розпаковані ваги за адресою тензора у відеопам'яті (src0->data). Якщо ви в сервері вивантажите, скажімо, модель Anima і завантажите на її місце Krea 2, драйвер NVIDIA виділить новій моделі ті самі звільнені адреси у VRAM. Без примусового скидання кешу ядро побачить знайомі адреси і підсуне новій моделі старі ваги від попередньої! Тому ми розділили стан кешу окремо для кожної відеокарти в системі (g_state[device]) і жорстко прив'язали його очищення (ggml_cuda_dp4a_clear_cache()) до моменту вивільнення контексту моделі (free_sd_ctx), при цьому не зачіпаючи покрокове вивантаження--offload-to-cpu.Захист від просідання
cuBLASу VAE. Оскільки декодер VAE та окремі допоміжні шари часто зберігаються у форматіFP16, існував ризик, що стандартна бібліотека NVIDIAcuBLASна картах Pascal спробує рахувати їх у нативному 16-бітному режимі і свалиться у той самий штраф швидкості1:64. Щоб перекрити цю шпарину, ми у файліggml-cuda.cuпримусово увімкнули режим накопичення уFP32(prefer_f32_output = true/CUDA_R_32F) для всіх операційGGML_TYPE_F16на архітектурі SM 6.1 при активному--dp4a.
Результати тестування на GTX 1070 8 ГБ: цифри, якість та стрес-тест
Теорія та код - це чудово, але давайте подивимось, як вся ця архітектура поводиться у реальних завданнях на нашій піддослідній GTX 1070 8 ГБ.
Базові заміри продуктивності (512×768, тайлінг VAE 512×512, енкодер на CPU)
Спочатку ми прогнали серію тестів у класичному вертикальному форматі 512×768, щоб оцінити не лише максимальний приріст із повним кешем, а й те, наскільки швидко працює наш другий рівень пам'яті (тимчасовий буфер Scratchpad при примусово вимкненому кеші CACHE_MB=0):
Сімейство моделі та квант | Режим роботи | Швидкість кроку | Чистий час семплінгу | Прискорення |
Anima (Q4_K), 20 кроків | Сток ( |
|
| — |
Anima (Q4_K), 20 кроків |
|
|
| +71.8% |
Anima (Q4_K), 20 кроків |
|
|
| +67.7% |
Anima (Q3_K), 20 кроків | Сток ( |
|
| — |
Anima (Q3_K), 20 кроків |
|
|
| +84.4% |
Anima (Q3_K), 20 кроків |
|
|
| +70.7% |
Krea 2 (Q3_K), 8 кроків | Сток ( |
|
| — |
Krea 2 (Q3_K), 8 кроків |
|
|
| +75.0%…+75.5% |
Зверніть увагу на цікавий технічний нюанс: у стоковому режимі молодший квант Q3_K на моделі Anima працює навіть повільніше за Q4_K (2.62 с/it проти 2.41 с/it), тому що стоковому ядру складніше розбирати непарні бітові маски 3-бітного формату на кожному кроці. У нашому ж режимі --dp4a з кешем обидва формати розпаковуються у плоский int8 лише один раз, тому Q3_K та Q4_K видають однакові 1.39–1.40 с/it, а приріст відносно стоку на Q3_K сягає 84.4%!
Окремо перевірили важку Z-Image (Q5_K) у високому портретному розширенні 832×1216 (2 кроки, --cfg-scale 1.0):
Режим роботи | Крок 1 (з ініціалізацією) | Крок 2 (усталений) | Семплінг разом (2 кроки) | Прискорення |
Сток (без |
|
|
| — |
Наша збірка ( |
|
|
| +78.1% |
На усталеному другому кроці ми отримуємо майже двократне скорочення часу очікування — з 10.24 с до 5.43 с.
Перевірка якості та швидкості у 768×768 (8 кроків, --seed 42)
Головне побоювання будь-якого ентузіаста, коли він чує про переведення активацій та уваги у INT8: «А чи не перетвориться картинка на мило з артефактами?». Щоб відповісти на це питання предметно, ми прогнали всі три сімейства моделей у розширенні 768×768 (8 кроків, --cfg-scale 1.0, фіксований --seed 42) і порівняли рендери напряму:
Сімейство моделі | Семплінг (Сток) | Семплінг (--dp4a) | Повний час (Сток → --dp4a) | Візуальний вердикт |
Krea 2 (Q3_K) |
|
|
| Повний паритет: пори шкіри, відблиск в оці, вії, латунні шестерні та плівкове зерно без жодного мила |
Z-Image (Q5_K) |
|
|
| Повний паритет: текстура шкіри, окремі волосинки, відблиски та метал абсолютно чисті |
Anima (Q4_K + Turbo LoRA) |
|
|
| Чіткий лайн, контраст та дрібні деталі без будь-якої деградації |
Стрес-тест у чесному FullHD (1920×1080) та моніторинг VRAM
Але чи витримає наша дворівнева схема пам'яті справжній краш-тест? Ми запустили генерацію у повноцінному FullHD (1920×1080) на важкій моделі Krea 2 (Q3_K) на тій самій 8-гігабайтній GTX 1070, паралельно знімаючи показники споживання відеопам'яті через nvidia-smi кожні пів секунди:
Метрика | Сток (без --dp4a) | Наша збірка (--dp4a) | Підсумок |
Крок 1 |
|
| у 1.78x швидше |
Крок 2 (усталений) |
|
| у 2.02x швидше |
Чистий семплінг (2 кроки) |
|
| у 1.88x швидше |
Декодування VAE (18 тайлів |
|
| повний паритет |
Загальний час генерації |
|
| економія майже 49 секунд |
Пікове споживання VRAM ( |
|
| лише +122 MiB (запас ~ |
Середнє споживання VRAM |
|
| +467 MiB |
Подивіться на ці цифри: на усталеному кроці у важкому FullHD ми отримали рівно двократне прискорення (2.02x) - 24.13 с замість 48.69 с! При цьому пікове споживання відеопам'яті зросло на смішні 122 мегабайти, залишивши понад 1.3 ГБ вільного запасу. Тобто наш лімітер у 1536 МБ та буфер Scratchpad відпрацювали як швейцарський годинник.
Наостанок ми перевірили ще важчу версію Krea 2 у кванті Q4_K (вага самого файлу — 6.72 ГБ) із увімкненим --offload-to-cpu все на тій же 8 ГБ GTX 1070:
У розширенні
512×512усталений крок прискорився з4.03 с/itдо2.52 с/it(1.60x), а загальний семплінг скоротився з15.15 сдо12.35 с.У важкому квадраті
1024×1024швидкість кроку зросла з18.34 с/itдо10.09 с/it(1.82x), зменшивши час семплінгу з44.47 сдо27.09 с.
Тепер найцікавіше, а саме, приклади генерацій і порівняння стокового ядра з нашим кастомним. Ще раз наголошую: чекпоінти та seed були однакові у всіх тестових прогонах, та на обох ядрах:
Anima (Q4_K + Turbo LoRA)
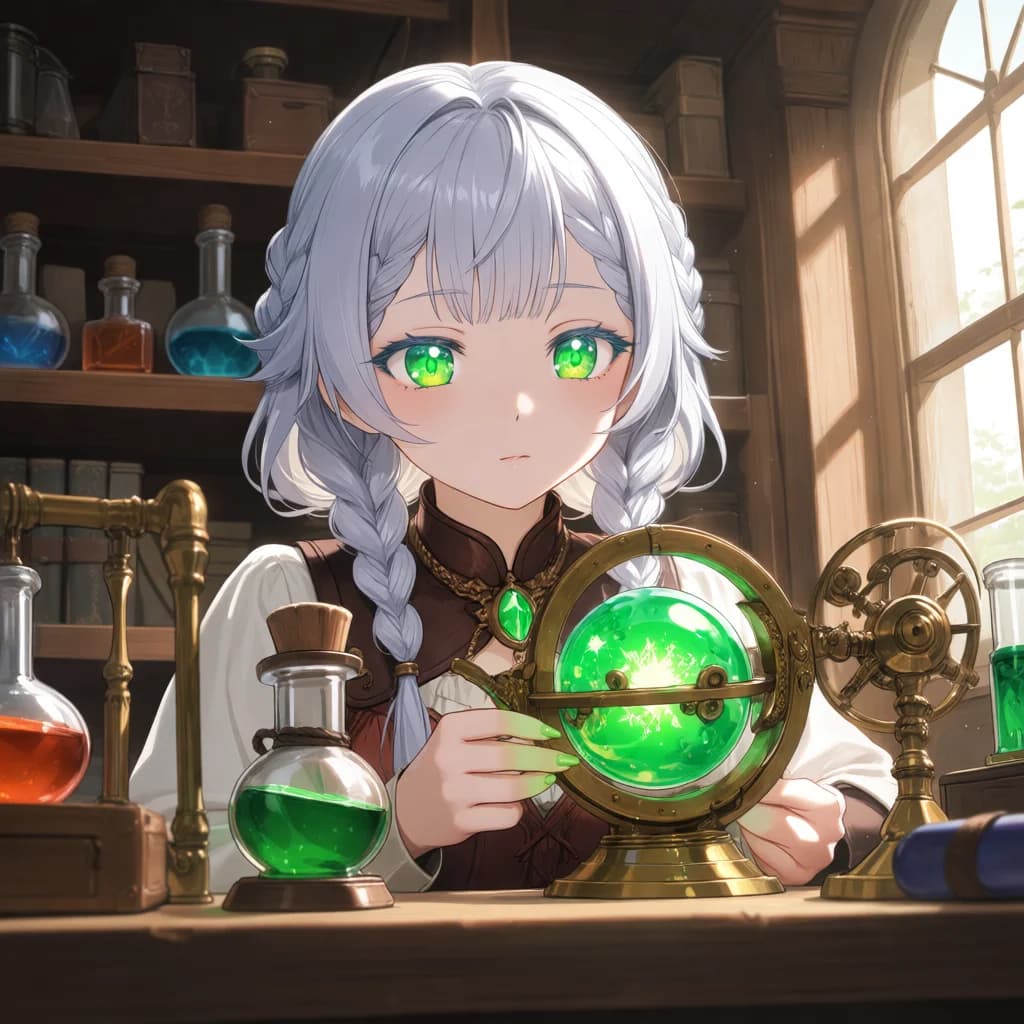
 DP4a (INT8)
Z-Image (Q5_K)
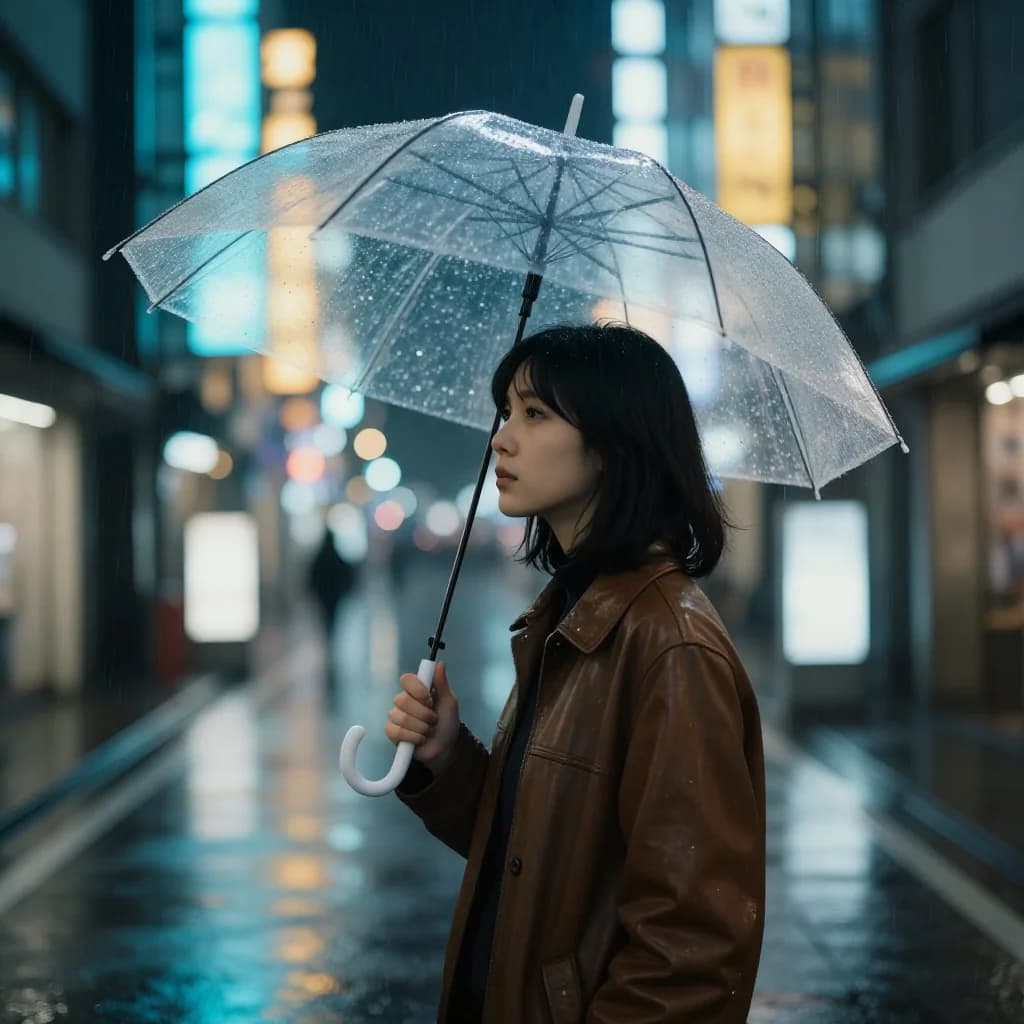
 DP4a (INT8)
Krea 2 Tutbo (Q3_K)
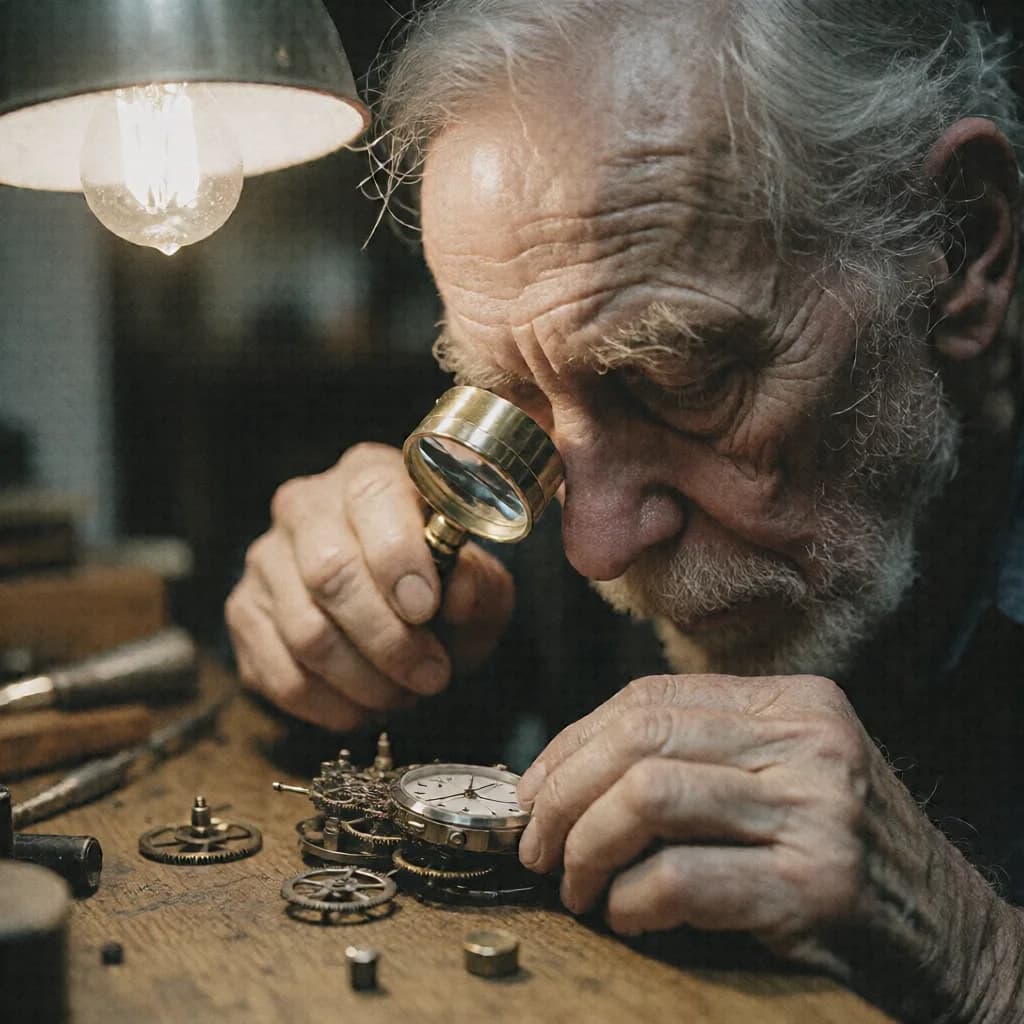
 DP4a (INT8)
Єдине, що можна помітити при прямому накладанні картинок одна на одну - помітні зсуви у розташуванні другорядних деталей на кшталт дрібних шестерень на фоні або положення пальців. Це абсолютно нормальний наслідок зміни порядку округлень при INT8квантуванні активацій на льоту; сама ж різкість, деталізація та світлотінь залишаються ідентичними стоку.
Обмеження та підводні камені
Я б не поважав себе як автора, якби показав вам лише красиві графіки прискорення і промовчав про нюанси. Будь-яка низькорівнева оптимізація має свої фізичні та архітектурні межі. Під час тестів ми з Гідрою зіткнулися з трьома важливими моментами, про які ви маєте знати заздалегідь:
1. Сирі .safetensors у форматі FP16 / BF16 не прискорюють лінійні шари напряму
Наше матричне ядро W8A8 __dp4a перехоплює виключно квантовані формати ваг (Q3_K – Q8_0). Якщо ви згодуєте програмі оригінальний неквантований чекпоінт у BF16 або FP16, наш бекенд прискорить лише блоки уваги FlashAttention (це дасть скромні +15–20%), а всі основні матричні множення підуть стандартним шляхом через cuBLAS.
Як це обійти без конвертації моделі на диску? Дуже просто: достатньо передати прапорець --type q8_0 при запуску .safetensors. У цьому випадку stable-diffusion.cpp прямо під час завантаження на льоту квантує ваги у 8-бітний формат Q8_0. Модель одразу займає вдвічі менше відеопам'яті, зберігає ~99% візуальної якості оригіналу і на повну вмикає наше прискорення __dp4a.
2. Пастка --offload-to-cpu та ggml_graph_cut: показовий кейс на P102-100 (10 ГБ)
Коли ми перенесли тести на наш «безголовий» майнерський прискорювач P102-100 10 ГБ, спливла дуже повчальна історія. Важка модель Krea 2 у кванті Q3_K (~5.3 ГБ) відпрацювала на P102 просто чудово (~200 секунд на важкому прогоні). А от коли ми спробували запустити ту саму модель у більших квантах Q4_K та Q4_0 (вага файлу 6.7–7.0 ГБ), час генерації раптово обвалився до ~450 секунд — тобто майже до рівня стоку!
І що найцікавіше: на 8-гігабайтній ігровій GTX 1070 той самий 6.72-гігабайтний файл Q4_K щойно в наших тестах чесно показав 1.82-кратне прискорення (10.09 с/it проти 18.34 с/it). Що за чортівня?
Розгадка криється у роботі прапорця --offload-to-cpu та планувальника ggml_graph_cut. Як тільки сумарний обсяг «ваги моделі + робочі буфери графа» (на P102 це зайняло 8.7 ГБ із 10 ГБ) перетинає внутрішній поріг одного суцільного сегмента, ggml_graph_cut починає примусово різати модель на ~33 дрібних сегменти по 13 тензорів у кожному. У логах це виглядає як нескінченні рядки loading tensors completed, taking 0.21s десятки разів на кожному кроці семплінгу! Тобто рушій починає безперервно ганяти шматки ваг із системної ОЗП у відеопам'ять через шину PCIe прямо під час обчислень.
На повноцінній GTX 1070 із широкою шиною PCIe 3.0 x16 ці пересилання проходять відносно безболісно. А от на майнерській P102-100, де шина фізично задушена до PCIe 1.0 x4, затик на перекачуванні гігабайтів даних туди-сюди повністю з'їдає весь виграш від швидкого ядра на GPU.
Висновок простий: якщо ви використовуєте майнерські карти серії P100 із повільною шиною PCIe та прапорцем --offload-to-cpu, критично важливо обирати такий квант моделі, який вкладається в один суцільний сегмент без розрізання графа (для 12-мільярдних моделей рівня Krea 2 на 10 ГБ карті ідеальний баланс — це саме Q3_K вагою ~5.3–5.5 ГБ).
3. Де ще працює ця архітектура за межами stable-diffusion.cpp? (Спойлер: ми вже імплантували її в 3D-авторигінг!)
Зв'язка нашого конвеєра W8A8 __dp4a, чесного FP32 софтмаксу у FlashAttention та блокування повільного FP16 1:64 у cuBLAS - це не якась специфічна милиця суто під генерацію картинок. Це універсальний рецепт для архітектури Pascal (SM 6.1), який дає кратний приріст скрізь, де відеокарта впирається безпосередньо в обчислення (compute-bound), тобто перемножує достатньо «широкі» матриці з розмірністю потоку даних M >= 16.
І щоб не кидатися голослівною теорією про те, що цей підхід міг би прискорити генерацію відео, аудіо чи фазу читання довгого промпту (prefill) у LLM, ми з Гідрою пішли далі і буквально імплантували наші ядра dp4a_gemm та fattn_dp4a у зовсім інший проєкт — генератор 3D-скелетів та скіннінгу для ігрових моделей (SkinTokens / skt_rig).
Для перевірки ми квантували базову модель skintokens з FP32 у формат Q8_0 (вага файлу на диску одразу схудла з 2075 МБ до 1354.7 МБ) і прогнали повний цикл генерації скелета на тестовій 3D-моделі (woman.sktmesh, beam = 10, --seed 42). Результати цього тесту — просто ідеальна ілюстрація фізики роботи GPU:
Режим роботи (skt_rig) | shape | cond | backbone (beam = 10) | fsq_decoder (J = 52) | Загальний час | Пік VRAM |
FP32 (еталонний сток) |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Подивіться, наскільки закономірно поводяться різні частини однієї нейромережі:
Там, де чип рахує важку математику (
fsq_decoder, де розмірність матриціM = 8192), ми отримали рівно 2.01-кратне прискорення (+101% швидкості)! Час роботи декодера впав із14.93 сдо7.42 с, а на виході ми отримали абсолютно той самий скелет на 52 кістки. До речі, увімкненняfattn_dp4aуFsqDecoderдало ще й приємний бонус по пам'яті: ядру більше не потрібно виділяти проміжний буфер увагиkq, що додатково розвантажило граф у VRAM.А от у блоці авторегресії (
backbone) приріст мінімальний (13.49 с→12.27 с). Чому? Бо приbeam = 10розмірність пакета становитьM = 10(менше за поріг ефективної утилізації тайлівM >= 16). На кожному кроці поштучного декодування відеокарта просто чекає, поки контролер пам'яті прокачає ваги з чипів GDDR5 (mmvq), а процесор відпрацює свої кроки. Тобто тут завдання є суто memory-bound (упирається у пропускну здатність шини пам'яті, а не в ALU чипа).
Саме тому важливо тверезо розуміти межі технології: під час поштучної генерації тексту у великих мовних моделях (batch = 1, M = 1) або в вузькій авторегресії ніякий W8A8 дива не зробить — там править бал виключно швидкість відеопам'яті. Але щойно з'являється щільний потік даних (дифузія, 3D-декодери, аудіо/відео, енкодери або батчевий prefill великого контексту в LLM) - наш нативний __dp4a конвеєр розкриває старі карти GTX 1000 та серію P100 на всі 200%!
Підсумки
Чи варто було витрачати стільки десятків годин на низькорівневу оптимізацію під архітектуру, якій у 2026 році вже виповнилося десять років? Як на мене - на всі сто відсотків так. І справа тут далеко не лише у нашій тестовій GTX 1070 8 ГБ чи майнерських P104-100 та P102-100.
Давайте подивимось на картину ширше. Що таке архітектура Pascal з індексом SM 6.1? Це ціла плеяда карт, які досі у величезній кількості живуть у домашніх ПК, робочих станціях та бюджетних AI-серверах. Окрім масових GTX 1060 6 ГБ, GTX 1070 Ti та GTX 1080, сюди входять справжні важковаговики на повному та майже повному кристалі GP102:
Народна легенда GTX 1080 Ti (11 ГБ) та її старші брати TITAN X (Pascal) і TITAN Xp (12 ГБ). З їхніми 11–12 гігабайтами швидкої пам'яті GDDR5X та широкою 352/384-бітною шиною наш конвеєр
W8A8 __dp4aдозволить крутити квантованіQ4_KтаQ5_Kчекпоінти сучасних дифузійних гігантів без жодного розрізання графа, маючи на борту шалені ~44–48 TOPS цілочисельної потужності.Серверний улюбленець ентузіастів локального ШІ - NVIDIA Tesla P40 (24 ГБ), а також професійна Quadro P6000 (24 ГБ). І ось для цих двох монстрів наше ядро стає буквальним квитком у друге життя! Чому? Бо маючи 24 ГБ VRAM, ви взагалі забуваєте про ліміти відеопам'яті: будь-яка важка модель рівня Krea 2, Z-Image або Flux не просто цілком залітає у пам'ять самої карти, а й на 100% розміщує там наш Persistent W8 Cache (Рівень 1). Жодного перекачування по PCIe, жодних компромісів — чистий конвеєр
128×128 __dp4aна всіх 3840 ядрах CUDA чипа GP102.
Тобто за фактом, коли софт перестає тупо битися головою об урізаний FP16 (1:64) і починає на повну використовувати апаратний INT8 __dp4a разом із правильним менеджментом пам'яті, старі добрі «Паскалі» перетворюються з повільних аутсайдерів на реально гідні обчислювачі, які генерують картинку майже вдвічі швидше за сток без жодної втрати візуальної якості.
Окремо хочу сказати про те, як саме народжувався цей проєкт. Для мене це був показовий приклад здорової інженерної синергії людини та ШІ. Якщо на старті з молодшою Gemini 3.8 Flash нам доводилося буквально воювати за кожну гіпотезу та виправляти дитячі одруківки в коді, то перехід на Gemini 4 Hydrogen (нашу Гідру) змінив правила гри. Коли ти сам чітко розумієш фізику заліза, бачиш, де саме захлинається пам'ять чи шина PCIe, і ставиш конкретне архітектурне завдання — інструмент рівня Гідри дозволяє реалізувати такі низькорівневі речі на C++/CUDA, на які в одного розробника пішли б місяці безсонних ночей над документацією NVIDIA.
Усі наші напрацювання, вихідні коди ядер dp4a_gemm.cu та fattn_dp4a.cuh, готові патчі для чистого апстриму stable-diffusion.cpp, а також вже зібрані бінарники під Windows (sd-cli_DP4a.exe та sd-server_DP4a.exe) ми відкрито викладаємо у публічний доступ. Забирайте, ганяйте на своїх GTX 1070, 1080 Ti, P104, P102, Tesla P40 чи Quadro P6000, інтегруйте у власні проєкти і обов'язково пишіть у коментарях, які цифри вийшли на вашому залізі.
Що ж, їжу для роздумів (і код для тестів) я вам надав, а зараз маю повертатися до стенду. Бо як ви вже здогадалися за спойлерами у тексті, в одному з наступних матеріалів на вас чекає детальний розбір польотів топового майнерського прискорювача на чипі GP102 - тієї самої P102-100 10 ГБ. Тож далеко не розходьтесь!
Посилання на репозиторій: sd-cpp-pascal-dp4a