БЛОГИ · ШІ ТА НЕЙРОМЕРЕЖІ
ОПУБЛІКОВАНО
ЧИТАННЯ31 хв
Друге життя P104-100: чи здатні майнінгові карти тягнути сучасний локальний ШІ?
Великий тест P104-100 та порівняння з GTX 1070, RTX 2060S, RTX 3090 та RX 470. Досліджуємо архітектуру Pascal, квантування KV-кешу, роботу з Gemma 4, Qwen 3.8 27B, Krea 2 та SDXL.
У переважної більшості користувачів спеціалізовані відеокарти NVIDIA лінійки P100 асоціюються з відвертим металобрухтом (хіба що за винятком народної P106-100, але це вже інша історія). І це недалеко від істини. Перед нами класичні «безголові» обчислювачі на архітектурі Pascal: дисплейні блоки в самому кремнії заблоковані, відеотракт на текстоліті не розпаяний, та ще й шина PCIe катастрофічно задушена до вкрай повільного режиму 1.0 x4.
Тобто, щоб наприклад пограти на цих картах в ігри, вам потрібно встановити кастомні драйвера (для Windows), та мати вбудовану графіку, або окрему, хай і будь-яку, але повноцінну відеокарту з активними відео-виходами. До того ж, не усі ігри зможуть адекватно працювати з шиною PCIe 1.0 x4, що може вилитись у над-низький FPS, або що ще гірше - у мікрофрізи.
Коротше кажучи, потенційних проблем з серією P100 у геймерів доволі багато. Але, що якщо ми спробуємо розглядати ці пристрої саме як CUDA прискорювачі? На щастя, у цьому випадку жахливо повільна шина PCIe не так часто стає на заваді потенціалу архітектури Pascal. Адже за фактом, якщо LLM вже завантажилась у відеопам'ять - їй практично не потрібно "ганяти" купу даних по шині PCIe (звісно, якщо ви не сплітите дифузну модель для генерації зображень на декілька GPU).
В цьому матеріалі ми обговоримо та протестуємо саме найдешевшого представника майнінгових карт - P104-100.
Ціноутворення P104
Отже, як так сталось, що саме мідл-енд рішення стало найдешевшим? Все доволі банально: P106-100 має можливість розблокування 16 ліній PCIe, хоч і тільки версії 1.0. В той час як топова P102-100 - це апріорі монстр продуктивності у серії, тому він фізично не може коштувати дешево. Таким чином, саме середня карта стала найдоступнішою у своїй лінійці. Але для ентузіастів це тільки плюс, бо ми можемо без особливих проблем отримати 8ГБ відеопам'яті за копійки.
Давайте трішки конкретніше: на момент написання цієї статті (кінець серпня-початок вересня 2026 року), P104-100 коштує на вторинному ринку від 550 до 900 гривень (12-20$), в залежності від стану прискорювача, моделі / виробника, наявності фірмового охолодження (більшість адаптерів постачалося без вентиляторів) та бажання продавця.
Декілька P104-100 що були придбані для цих тестів, ми змогли забрати по 600 грн за одиницю, що еквівалентно 12 доларам. І я вважаю, що ця ціна є максимально адекватною: картам більше 6 років (деяким вже за 8-9) і по суті, вони вже давно відпрацювали свій ресурс. Тому платити більше ніж 15 баксів - це очевидний ризик. Але про це трішки пізніше, а поки, нумо подивимось на самі прискорювачі.
Zotac P104-100
Фото та загальний огляд
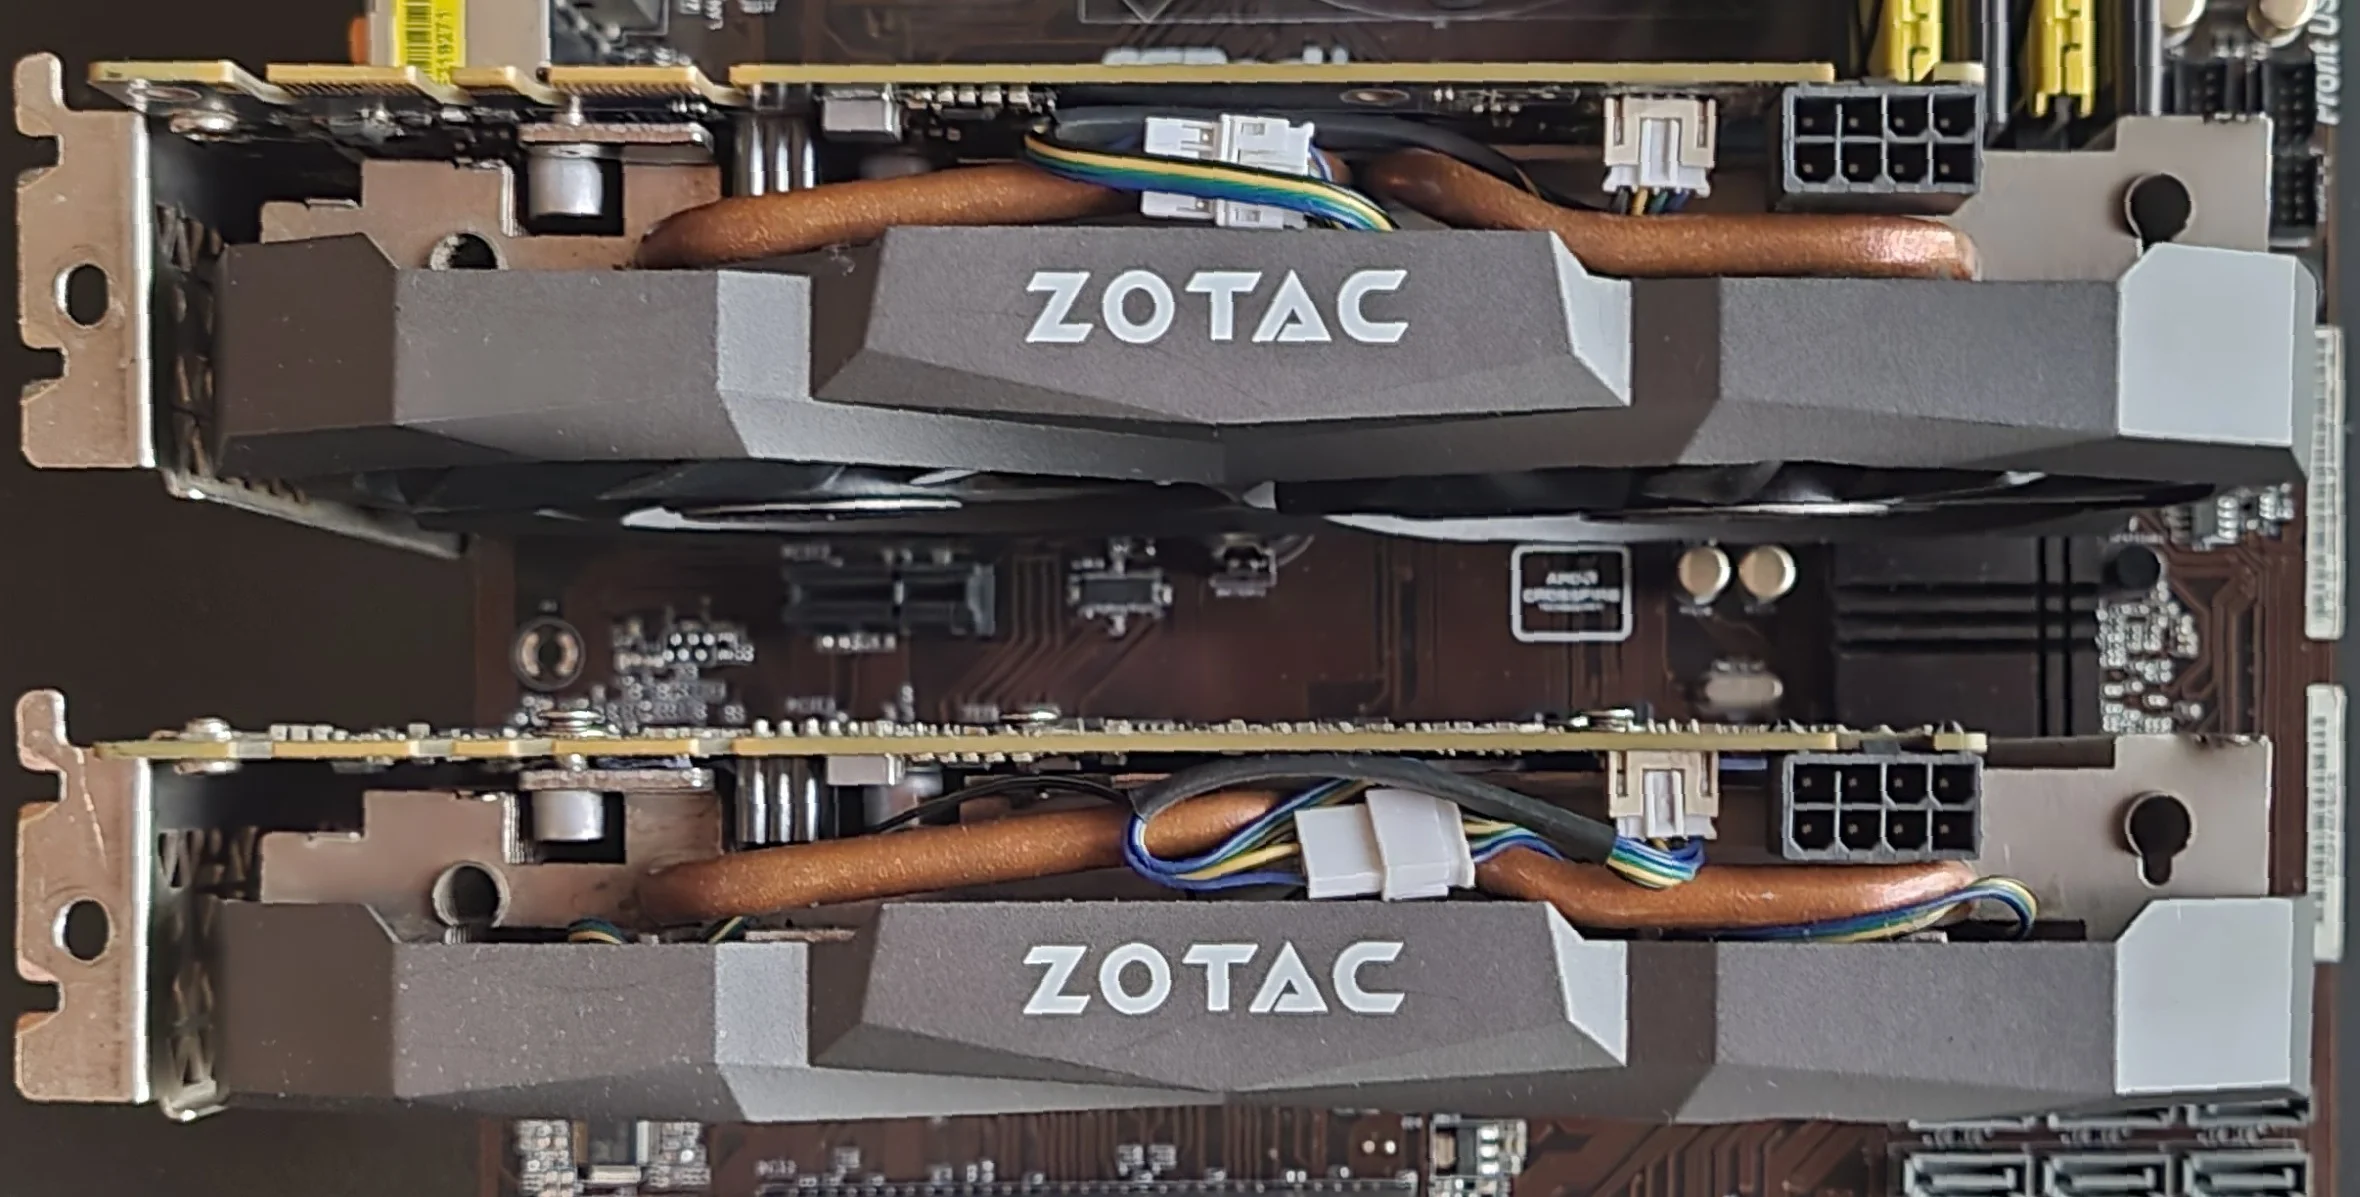
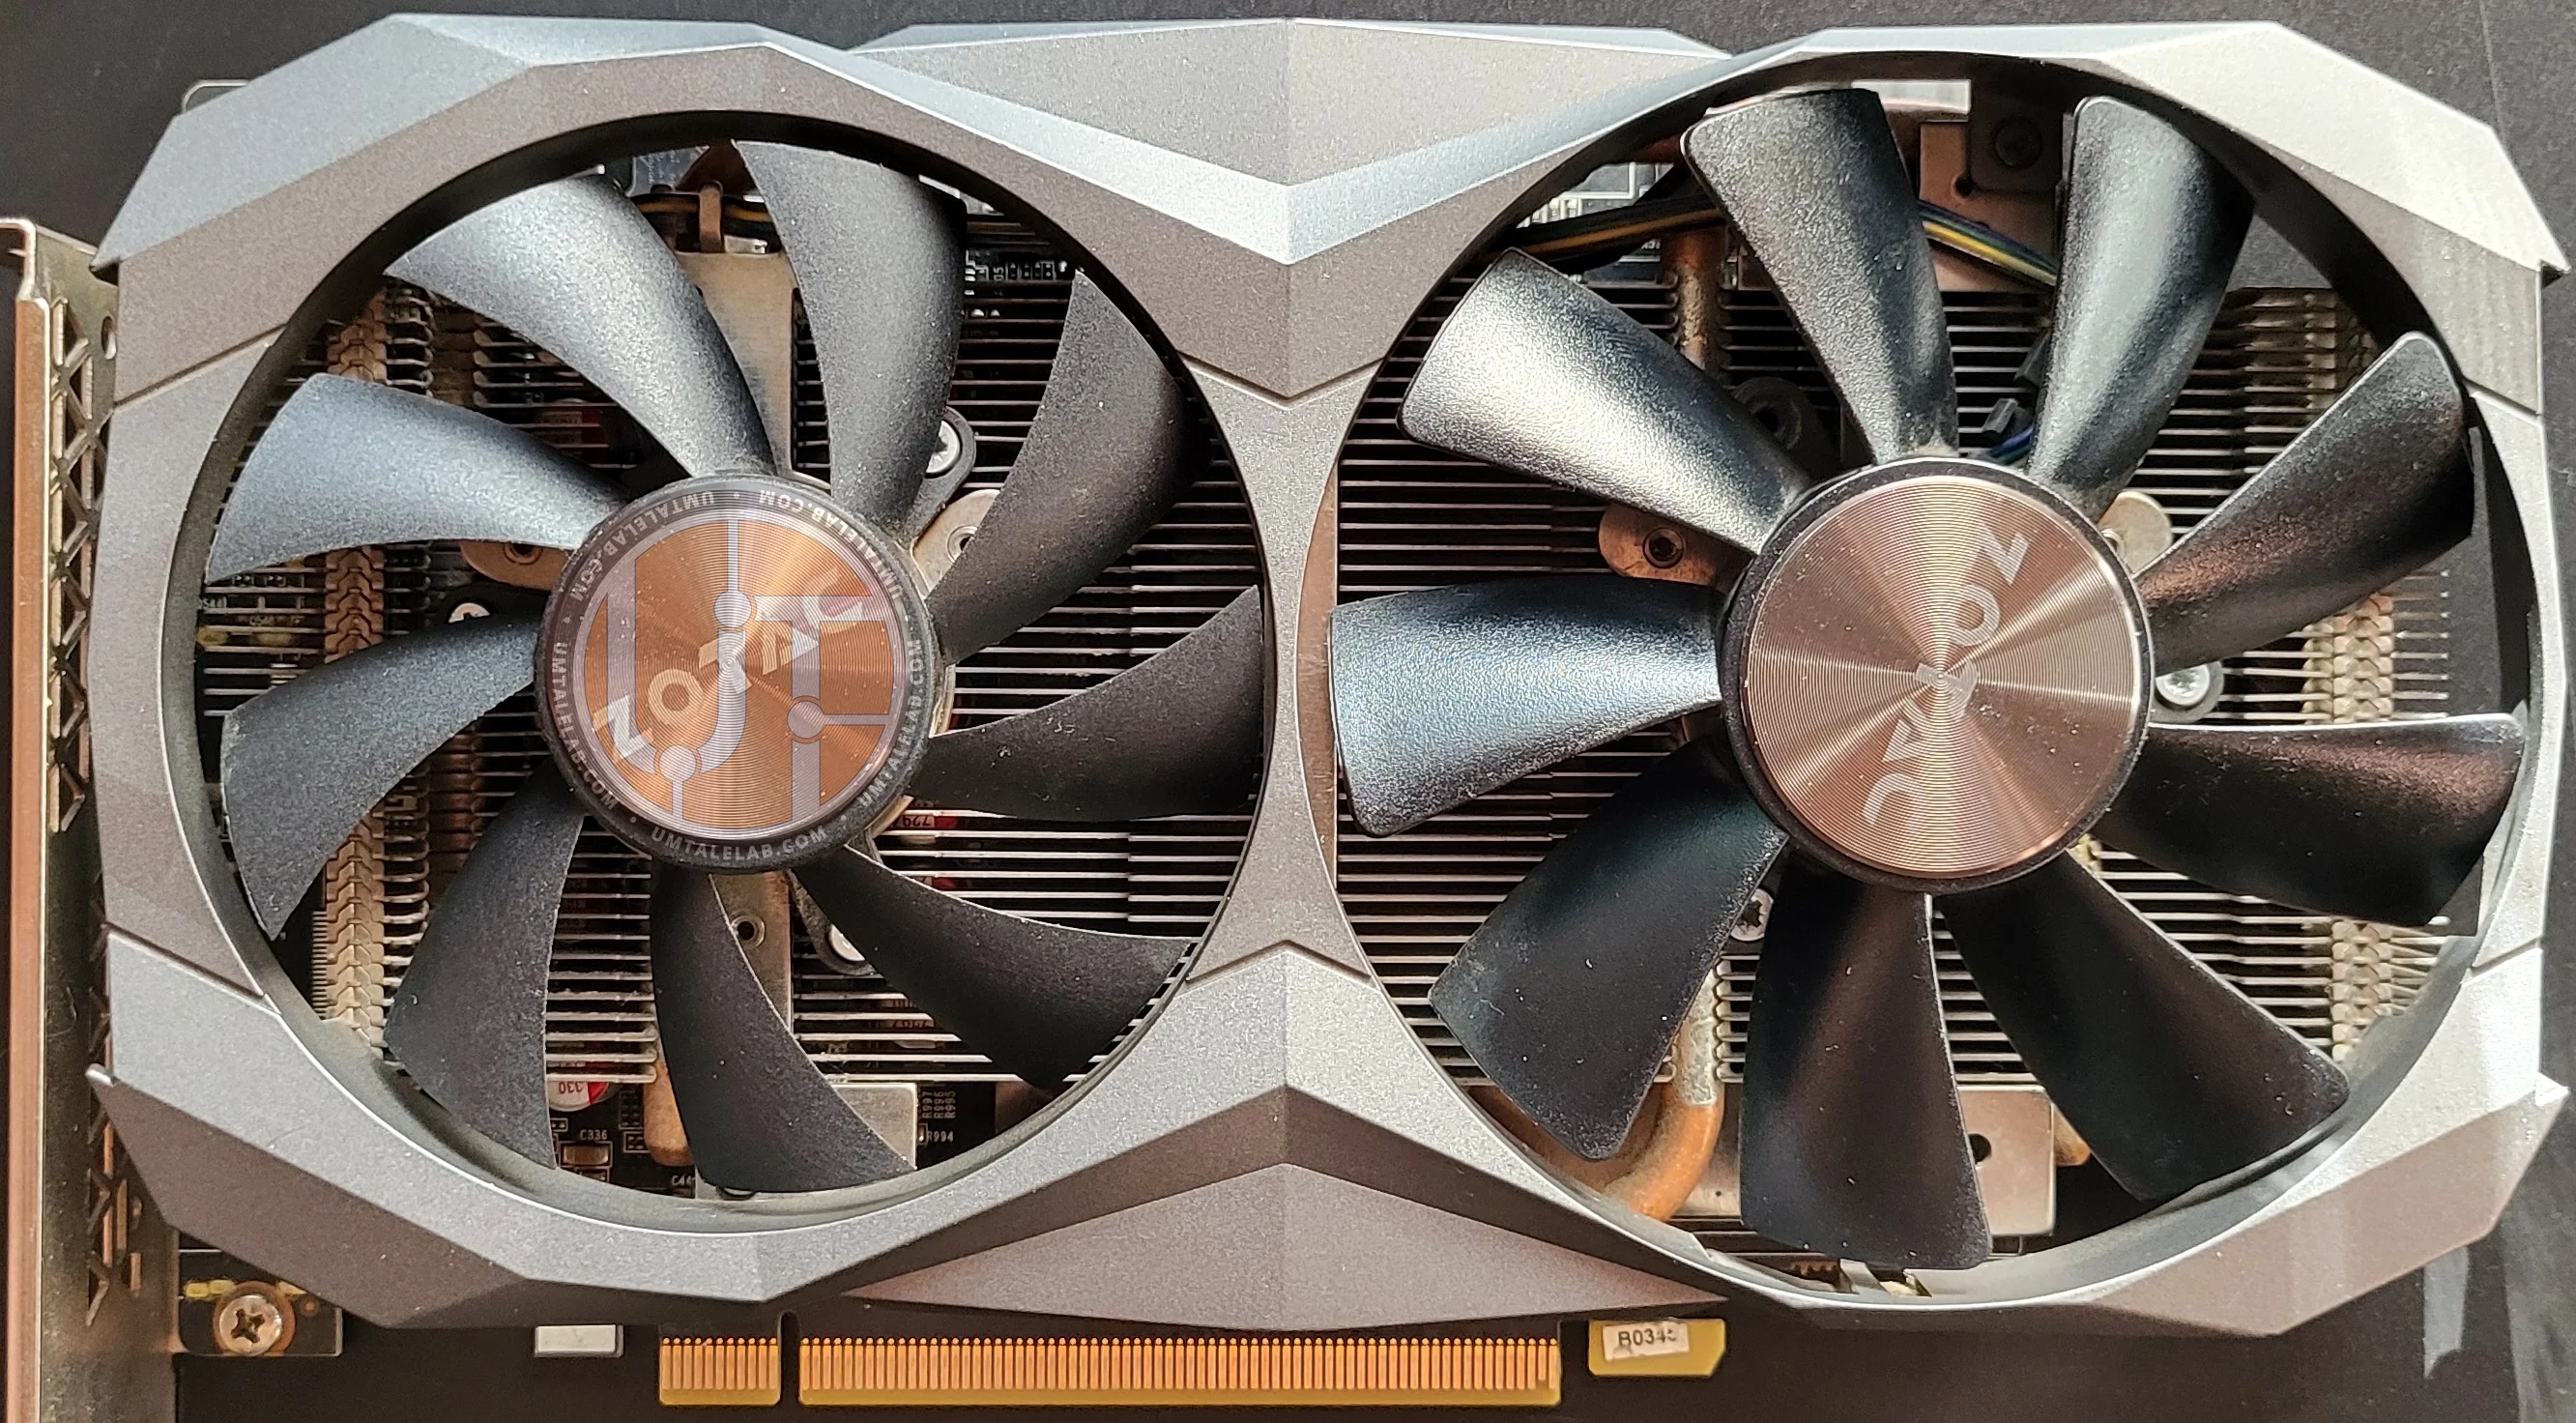
Перед вами P104-100 у виконанні фірми Zotac. На жаль, я не зміг знайти реальні фото і з'ясувати, як саме ці прискорювачі виглядали з заводу. Адже коли ми їх отримали, виявилось, що минулий власник замінив вентилятори на схожі, але не за розмірами кріплень. На фото видно, що "вертушки" вкручені прямо в ребра радіатора. Що, до речі, дуже небезпечно, бо є неілюзорний ризик вкрутити гвинтик (або ще гірше, - саморіз) у теплову трубку.
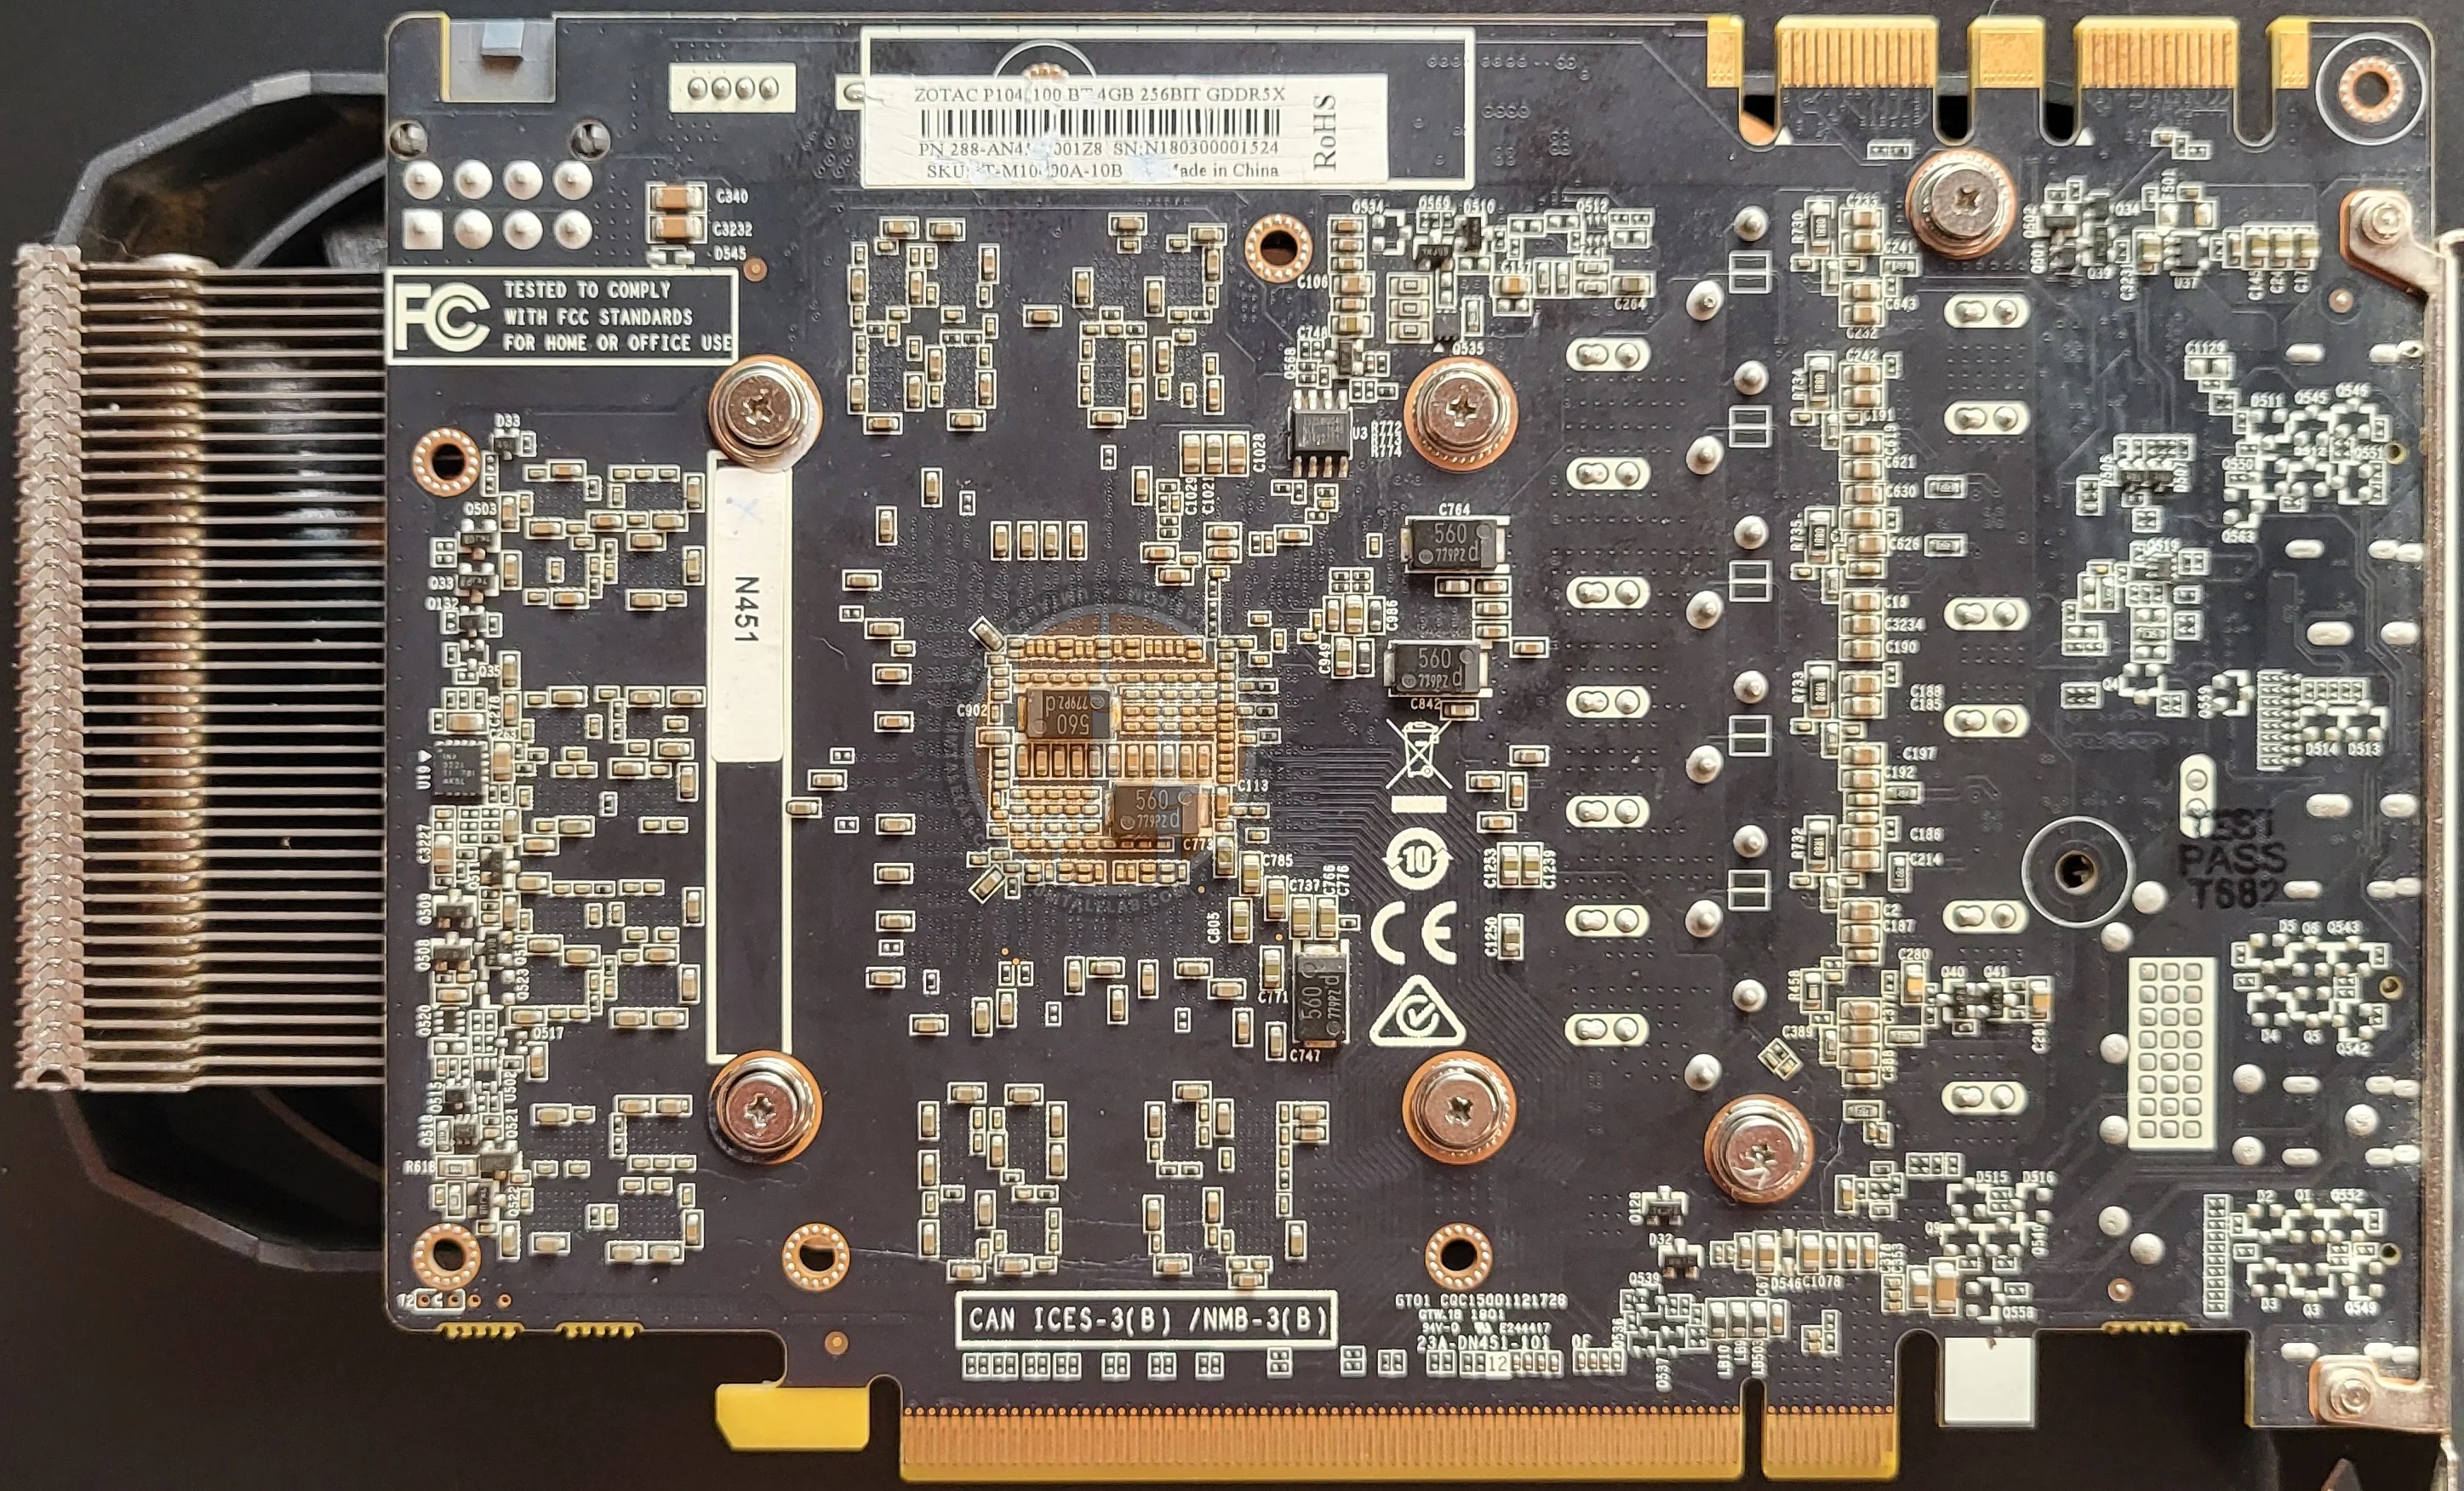
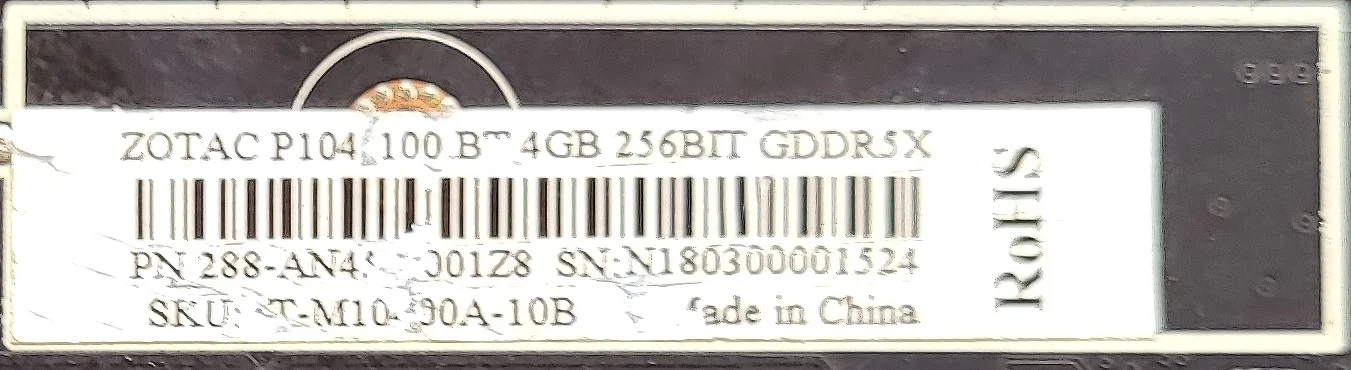
На зворотному боці плати можна побачити назву моделі та обсяг активної відеопам'яті з заводу.
 ⤢ ВІДКРИТИ
Чому саме "активної"? Все дуже просто: зараз ви навряд чи знайдете у продажу прискорювачі P104 з рідним BIOS. Більшість майнерів перепрошили свої карти та активували повний обсяг доступної VRAM. Для P104-100 це 8 GB GDDR5X. Як ви вже напевно здогадалися - придбані зразки вже мали на своєму борту необхідну версію BIOS.
Графічний процесор та відеопам'ять
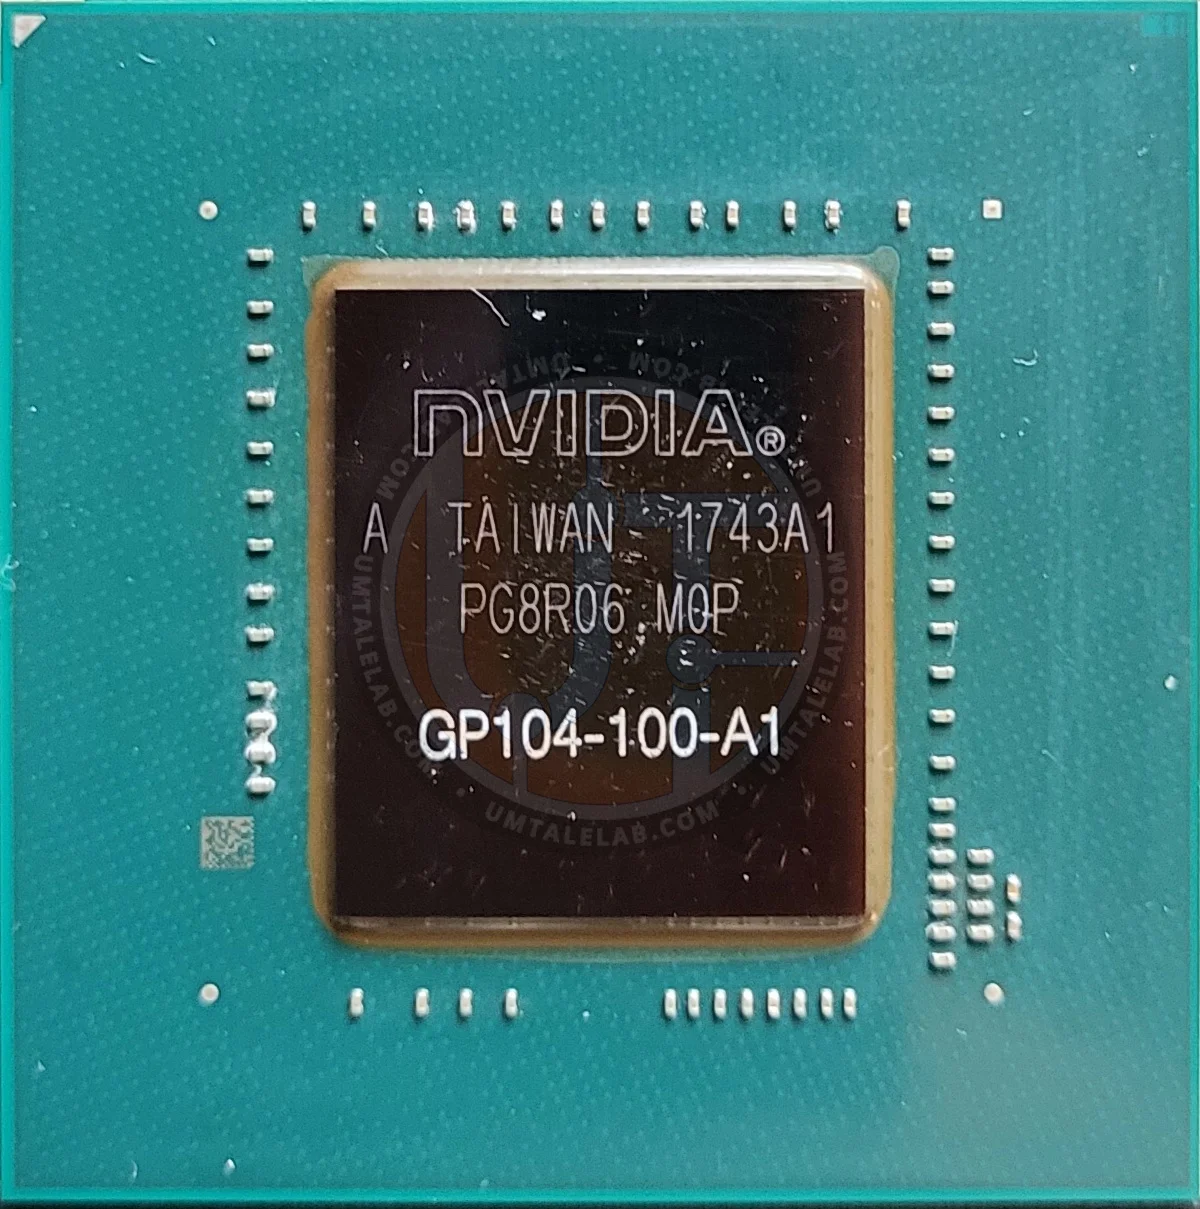
В якості GPU на прискорювачі розпаяний 16-нм чип GP104-100-A1 у конфігурації з 64 блоків рендерингу, 120 текстурних блоків та 1920 потокових процесорів.
 ⤢ ВІДКРИТИ
Наскільки мені відомо, графічний чип GP104-100-A1 не використовувався в жодній споживчій карті, окрім P104-100.
Тепер щодо стану: якщо ви подивитесь на компаунд навколо кристала, навіть неозброєним оком помітно, що він має світло-бурий відтінок. Що це означає на практиці? Доволі сумну картину: нормальний (заводський) колір компаунду у більшості GPU - кремовий, світло-сірий, або сірий. Така зміна відтінку - з сірого на коричневий - неприродна. Зазвичай таке стається через те, що GPU працював при критично високих температурах довгий час.
А це вже тривожний дзвіночок: з огляду на те, що контролер пам'яті в GP104 (та й в багатьох серіях GPU - GP10x, TU10x, GA10x, AD10x, тощо), скомпонований по краю кристала впритул до компаунду перевернутою літерою "Г", перегрів цієї зони загрожує деградацією кремнієвих транзисторів самого КП або виконавчих блоків.
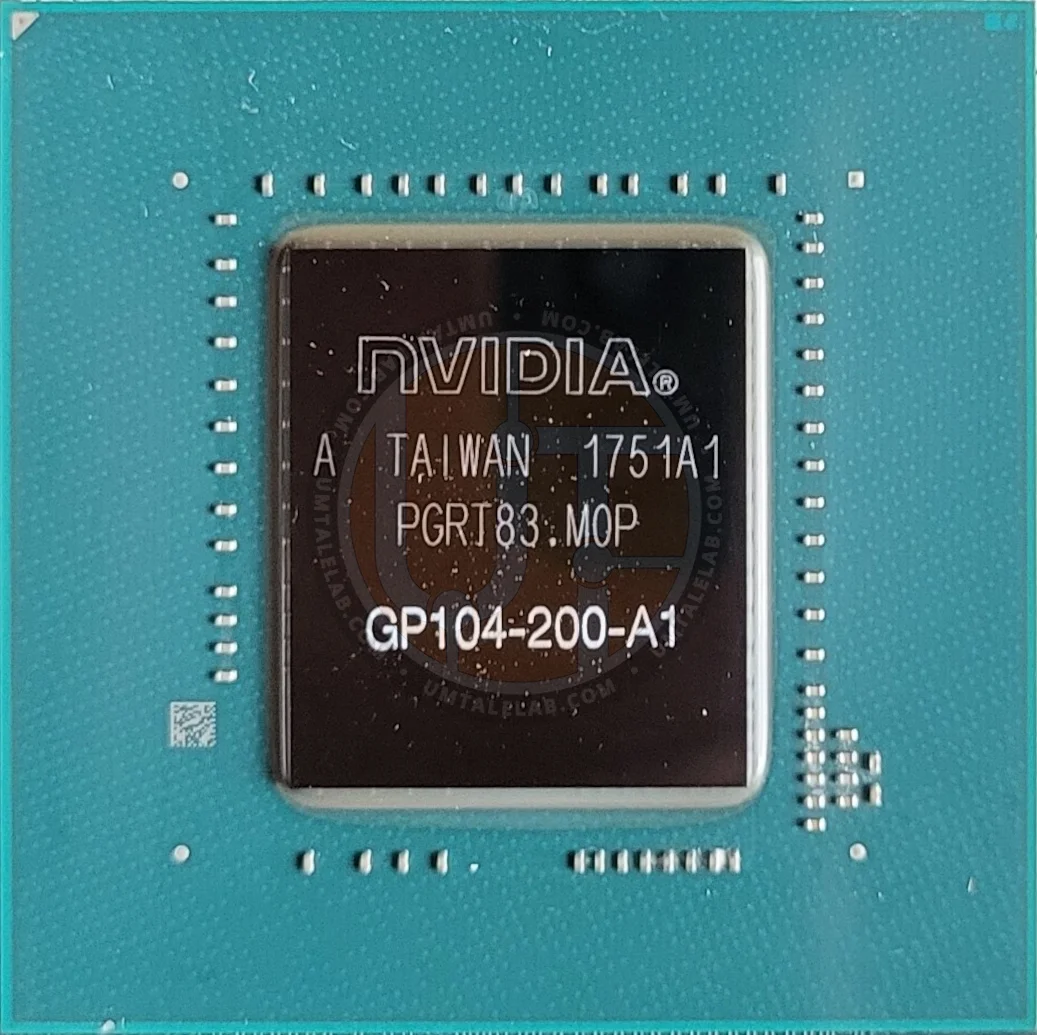
Щоб не бути голослівним, я паралельно розібрав стендову GTX 1070 і зробив декілька фото її GP104-200-A1 для наочного порівняння:
 ⤢ ВІДКРИТИ
Наголошую: це не новий GPU - нашій GTX 1070 більше 9 років. Проте, вона ніколи не перегрівалась і її GP104 не бачив температур вище 60 градусів (71 hot spot). Ось порівняння обох графічних чипів:
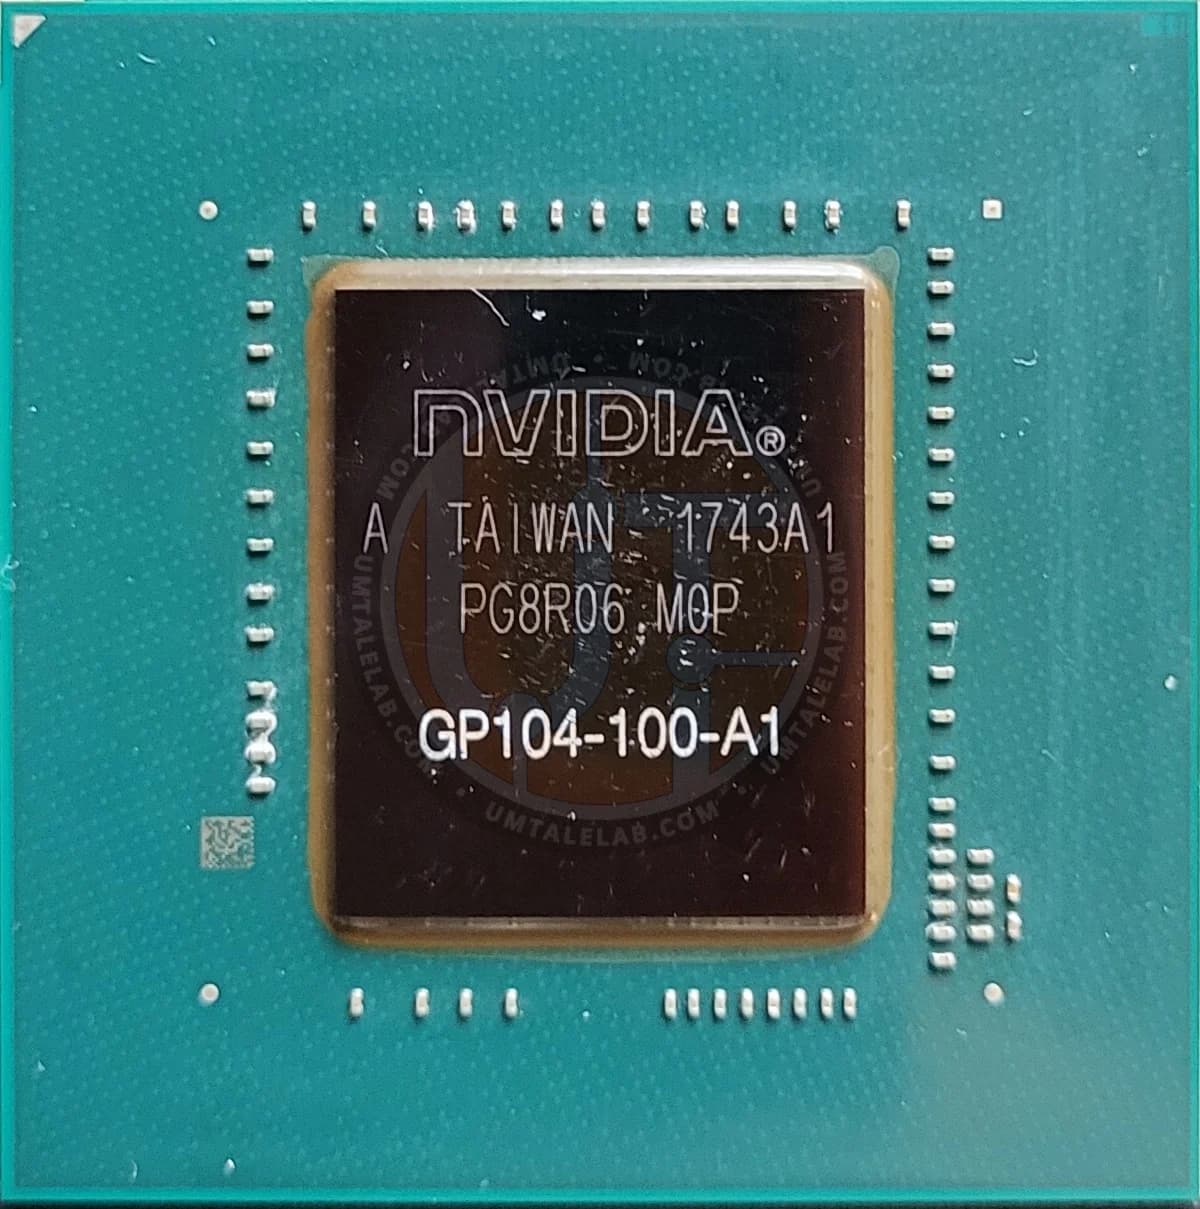
 GeForce GTX 1070 (GP104-200-A1)
Як бачите, різниця в кольорі компаунду вельми суттєва. За моїми спостереженнями (а за фактом і за загальними), кольором свого компаунду чіпи GP1xx м'яко натякають на те, що "жити" їм залишилось недовго. Так було з GP106 на стендовій GTX 1060 3GB, яку ми колись купували для тестів, так було купою відеокарт, які я ремонтував (GTX 1080 Ti тощо). Бурий/коричневий компаунд з часом веде до помилок в MATS по всіх чипах відеопам'яті, а далі - GPU в смітник.
Так до чого це все? Сенс мого довгого спічу полягає у тому, що купуючи подібні адаптери після майнінгу, особливо P100 серію, можна натрапити на ось такі екземпляри. І скільки вони проживуть під нейромережевим навантаженням - сказати складно. Тому будьте уважні і перевіряйте стан прискорювачів перед придбанням.
 ⤢ ВІДКРИТИ
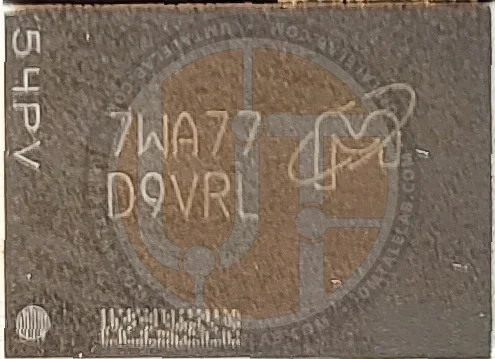
Відеопам'ять тестового зразка P104-100 набрана вісьмома "банками" з маркуванням 7WA77 D9VRL. Це 8-гігабітні (1 ГБ) чипи, розраховані на роботу на швидкості 11 000 МТ/с, реальна (фізична) частота - 1375 МГц. Потенційно, в заводському стані, ці банки легко розганяються до 1500 МГц (12 000 МТ/с).
Аналіз друкованої плати
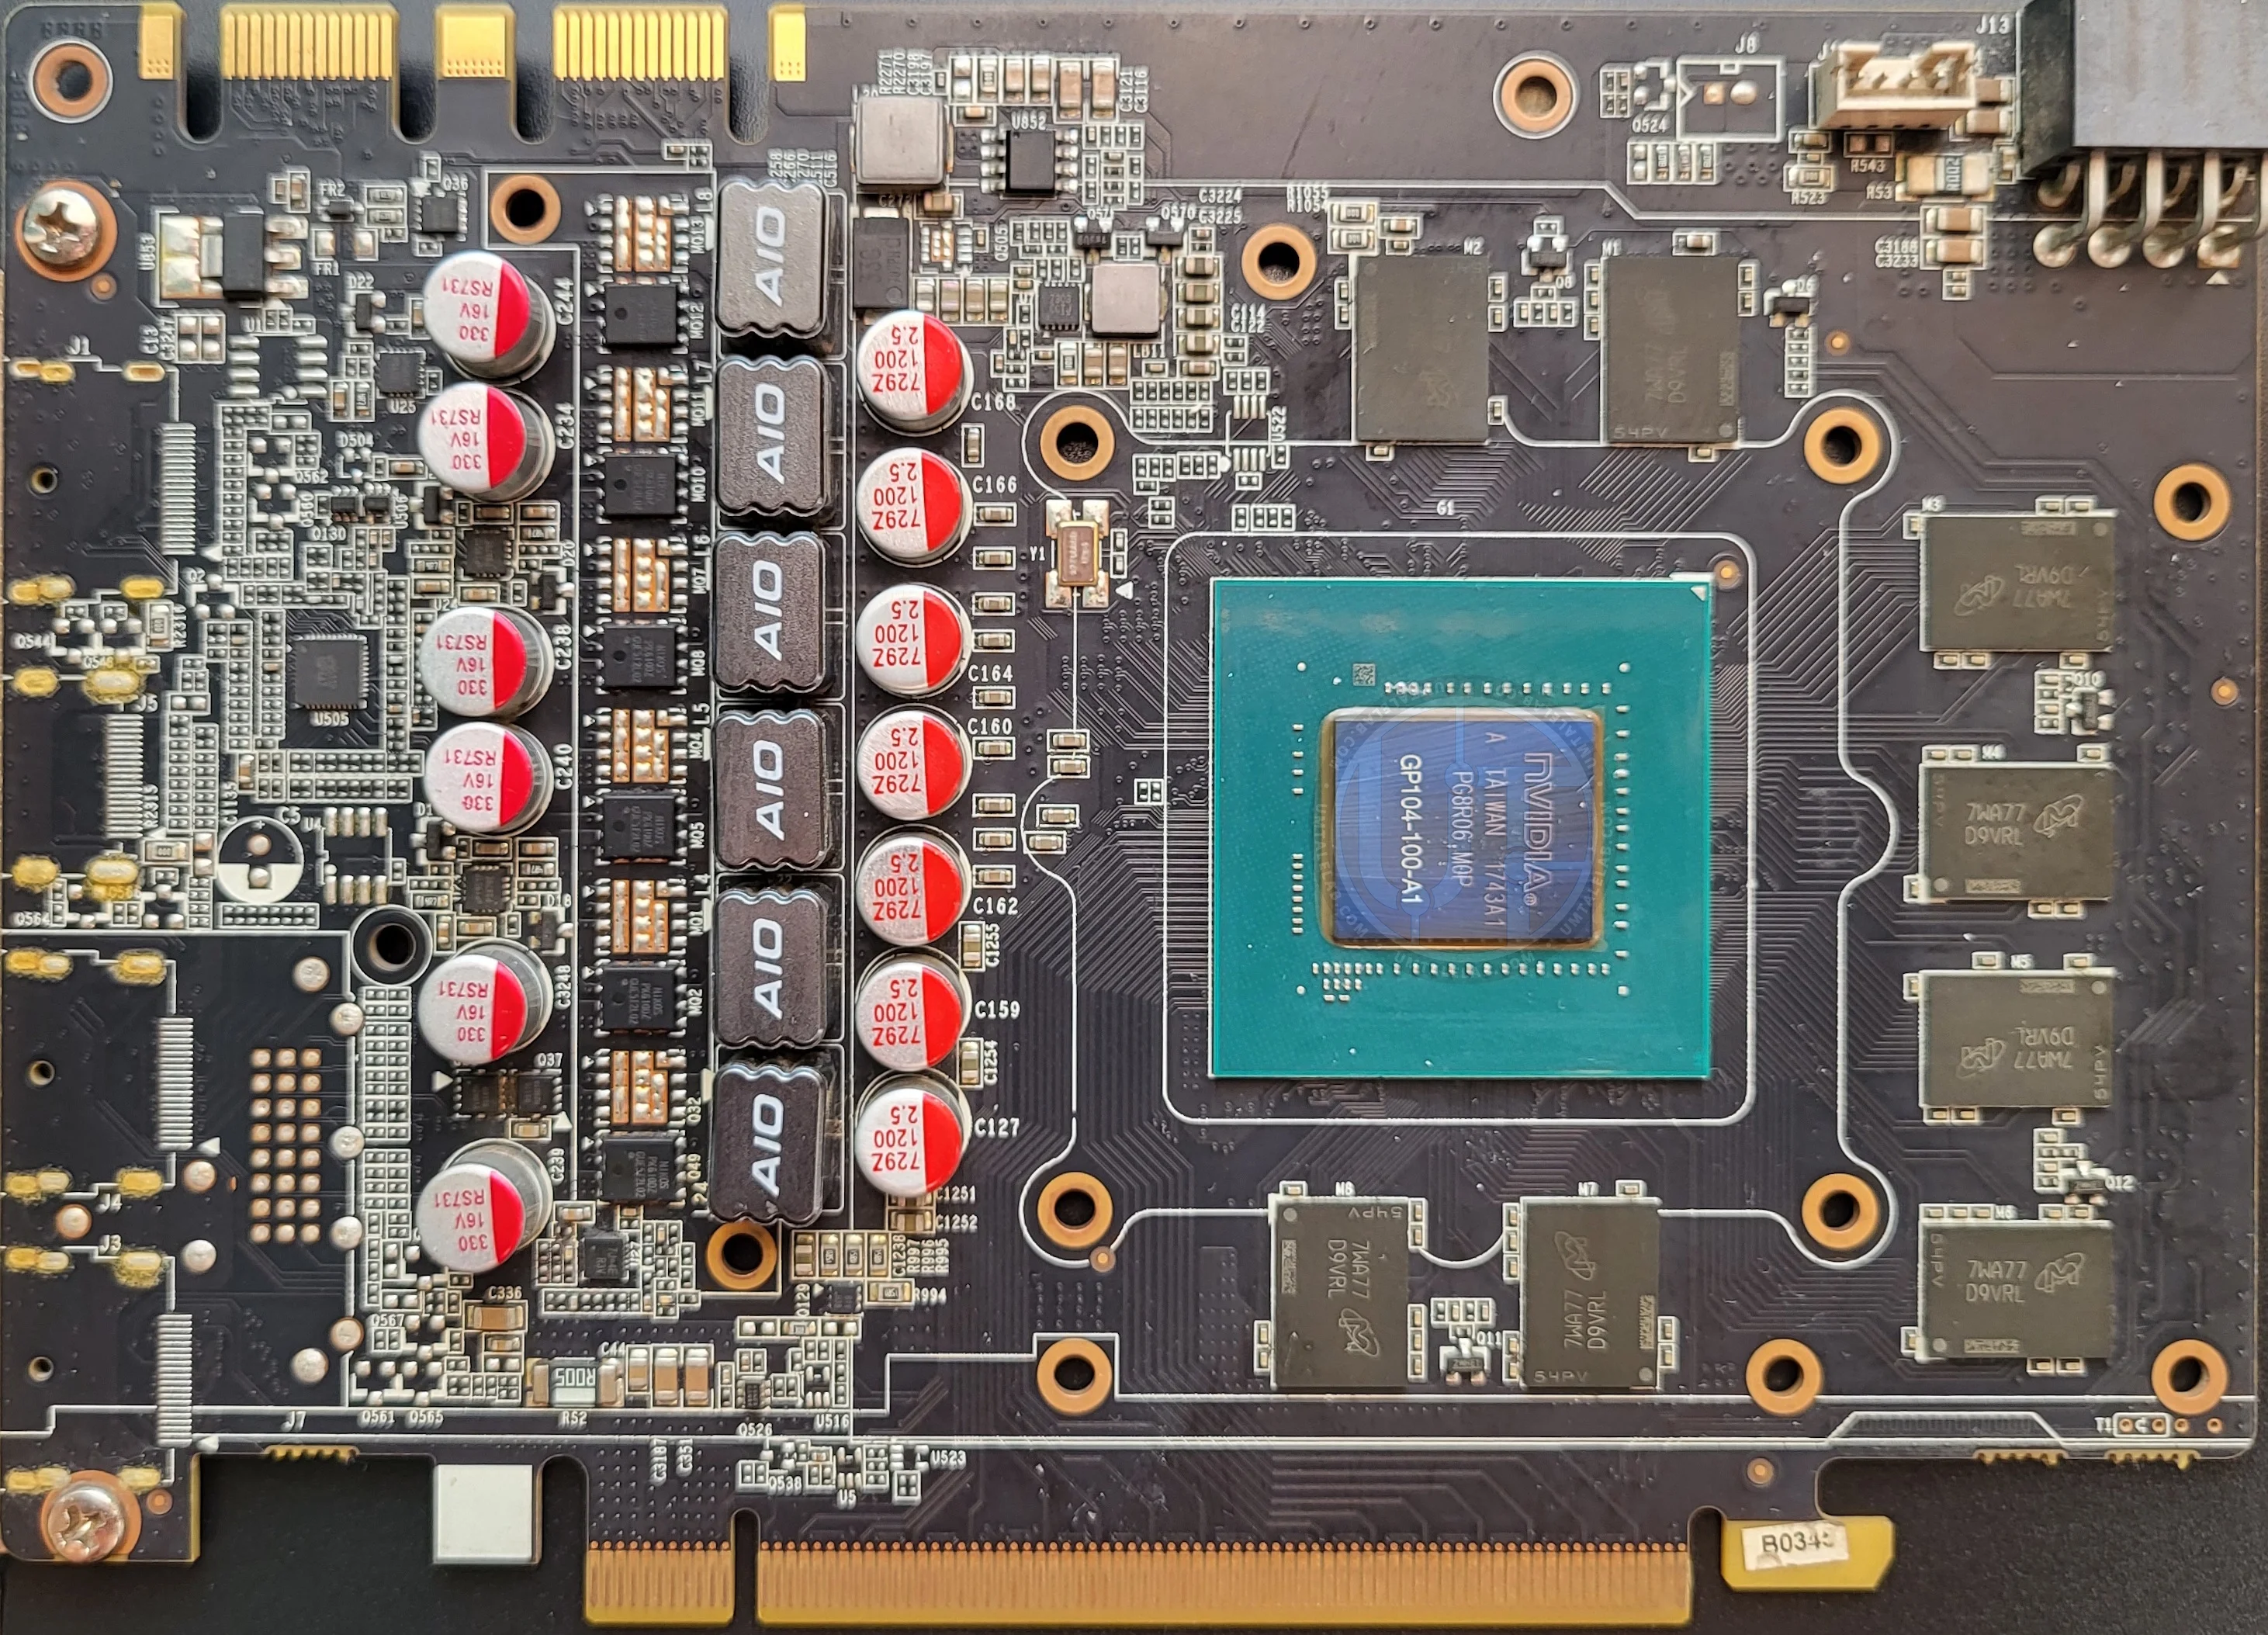
Модель Zotac P104-100 має абсолютно таку саму друковану плату, як і Zotac GeForce GTX 1080 Mini 8 GB.
 ⤢ ВІДКРИТИ
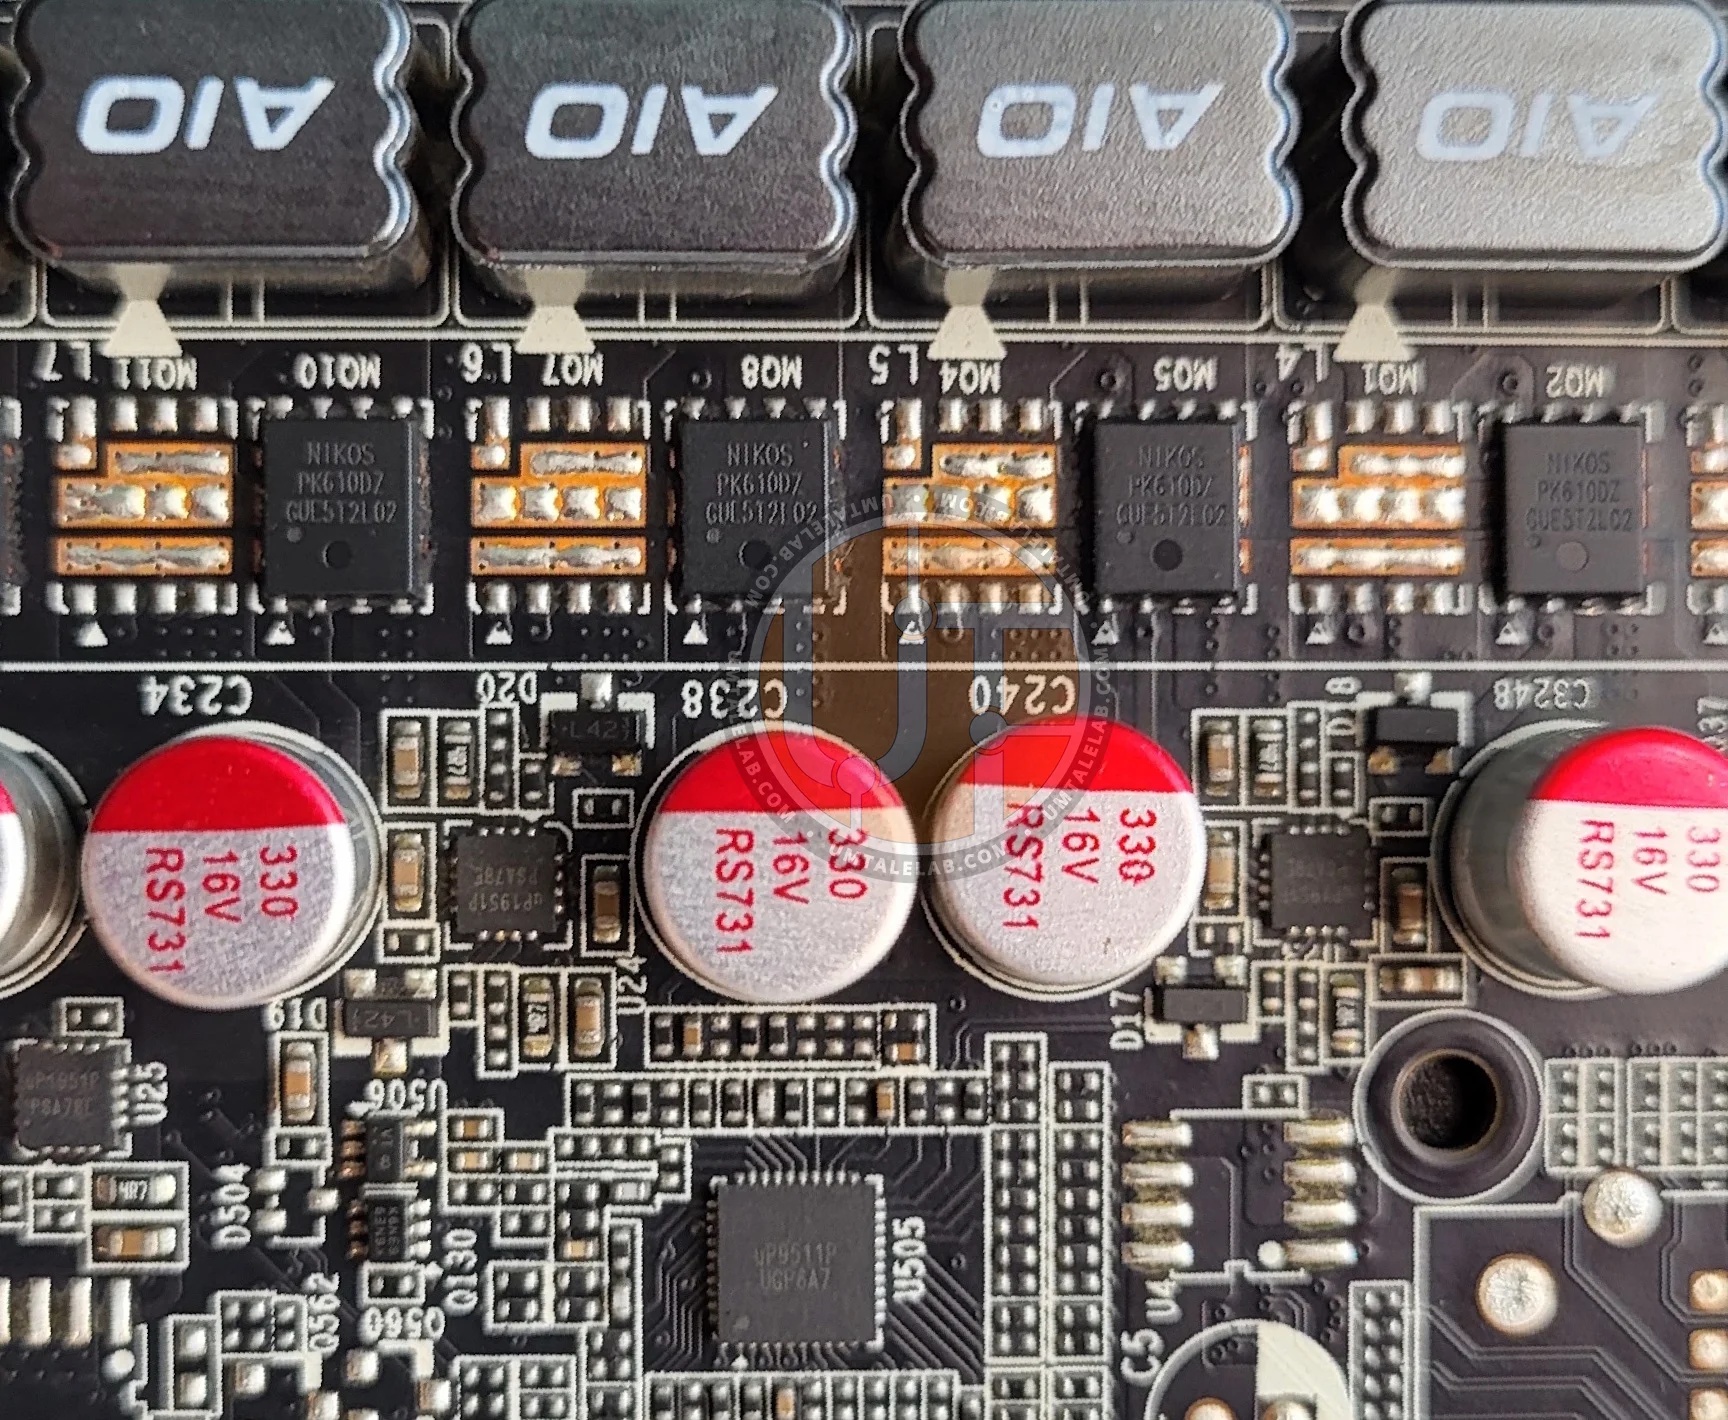
Єдине, що очевидно, на ній немає відео-виходів, супутньої обв'язки, та роз'єму RGB. Але загалом, ця плата - сестра-близнючка GTX 1080 Mini:
 ⤢ ВІДКРИТИ
Ті самі 5+1 фаза живлення GPU та GDDR5X, набрані здвоєними N-канальними мосфетами NIKOS PK610DZ під керуванням драйверів uP1951, та аналогічного ШІМ-контролер uP9511P.
Що ж, перед нами типова обрізана відеокарта лінійки GeForce GTX 1000, а саме, дуже близький аналог GeForce GTX 1070. P104-100 має ті самі 1920 CUDA-ядер, 120 текстурних блоків (TMU), 64 блоки растеризації (ROP), та 256-бітну шину пам'яті. Але тип відеопам'яті у P104-100 зовсім не від звичайної GTX 1070. З якогось дива компанія NVIDIA розщедрилась і вирішила використати дорожчу пам'ять GDDR5X. Таким чином, ми маємо неіснуючу у природі, та звісно дуже умовну GeForce GTX 1070 SUPER. І це вкрай приємна новина, адже у світі ШІ висока пропускна спроможність пам'яті (ПСП) рідко буває надлишковою.
Тестовий стенд та програмне забезпечення
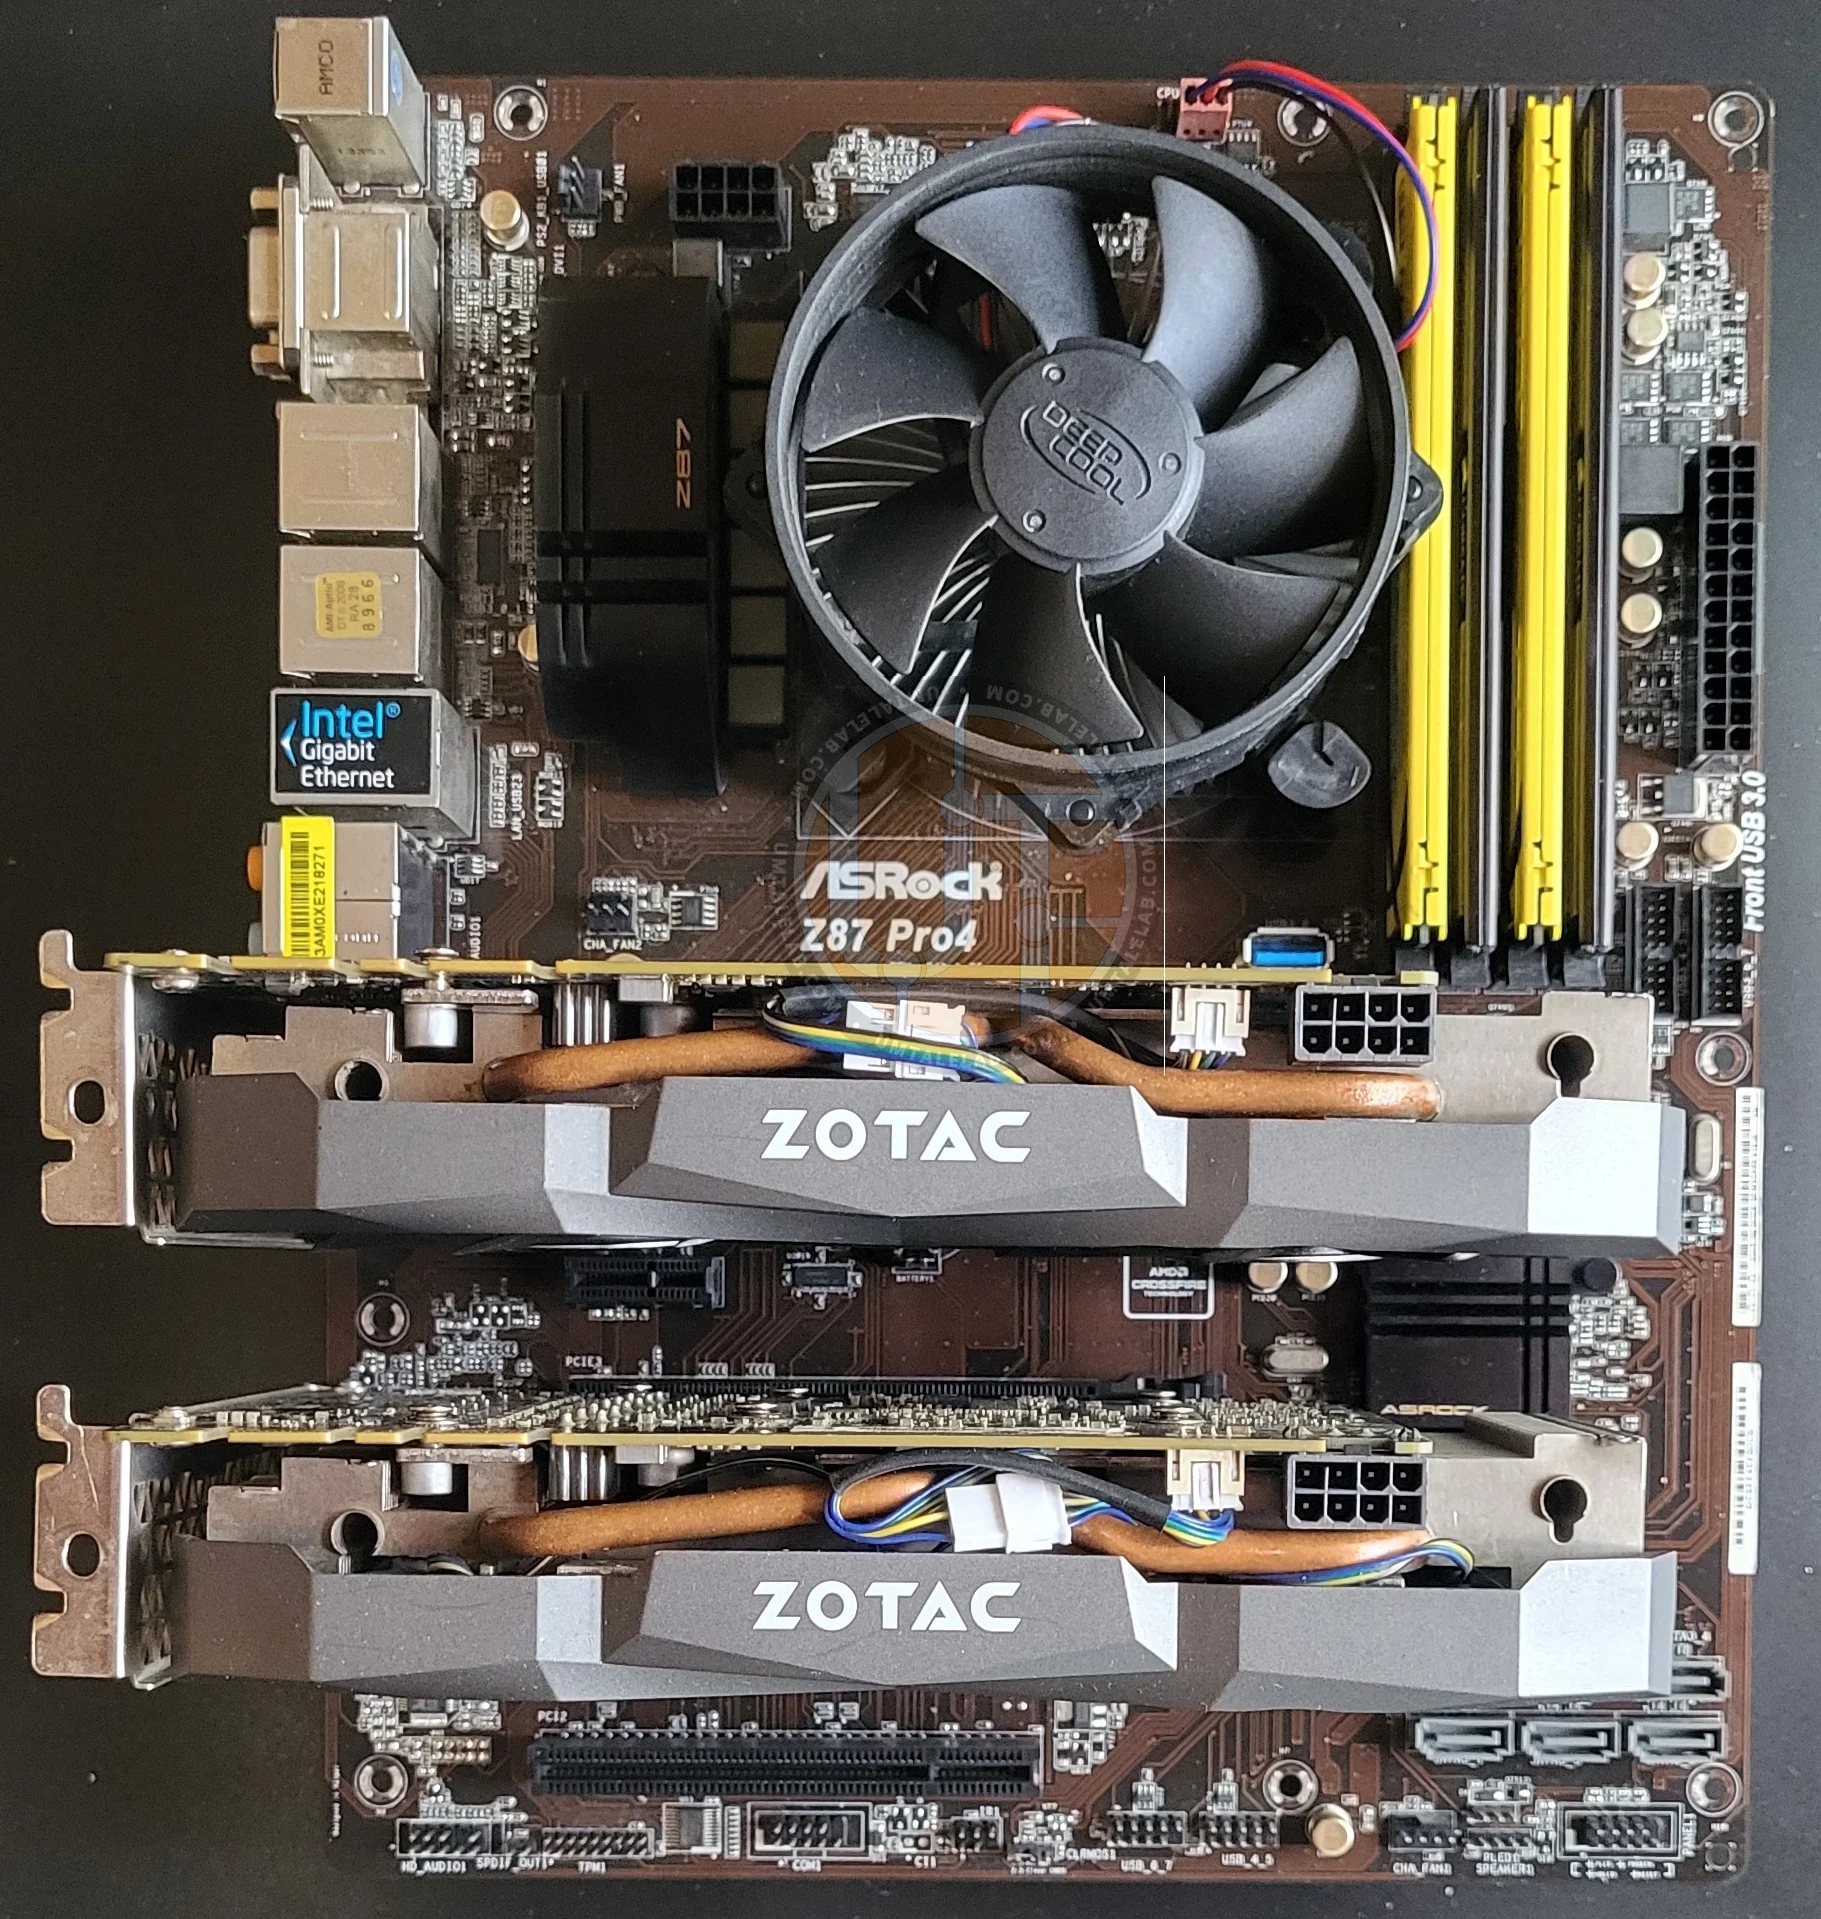 ⤢ ВІДКРИТИ
Залізо
Процесор - Intel Core i5-4670K;
Материнська плата - ASRock Z87 Pro4;
ОЗП - 24 GB DDR3 1866 MHz, набрані 4 модулями: 2 x 8 GB, 2 x 4 GB.
Відеокарти - Zotac P104-100 8GB, Manli Gallardo GTX 1070 8GB, KFA2 RTX 2060 SUPER EX 8GB, Palit Gamerock RTX 3090 24GB, Sapphire Nitro RX 470 8GB;
Накопичувач - Kingston 120GB;
Блок живлення - Chieftek GPS-1250C.
Я спеціально обрав максимально бюджетну основу для міні-серверу на базі P104-100, щоб показати на реальному прикладі - для забезпечення навантаженням 16 ГБ відеопам'яті на чипи GP104 не потрібні умовні китайські плати, відносно дорога DDR4, або купа ліній PCIe в Xeon LGA 2011 v3. Причому, вам навіть не обов'язково повторювати мою збірку. Все що вам необхідно, це: 4-ядерний CPU з вбудованою графікою та підтримкою інструкцій AVX2, мінімум 16 ГБ DDR3 (двоканальна), з частотою 1600 МГц, та будь яка материнська плата з двома механічно повнорозмірними роз'ємами PCIe х16 (електрично другий роз'єм на платі може мати 4 лінії, але головне - щоб фізично в нього можна було вставити повноцінну карту; або ж використовуйте райзери).
ПЗ
Операційна система - Linux EndeavourOS з останніми оновленнями на серпень 2026 року;
Llama.cpp - збірка , "fat binary" з урахуванням бекенду CUDA (активні архітектури Pascal 61, Turing 75, Ampere 86) та бекенду Vulkan;
Stable-diffusion.cpp - збірка , "fat binary" з урахуванням бекенду CUDA (активні архітектури Pascal 61, Turing 75, Ampere 86) та бекенду Vulkan;
В якості операційної системи було обрано актуальний реліз Linux EndeavourOS, що очевидно було помилковим рішенням. Це Arch-based дистрибутив, а це означає що він є rolling-release. Тобто у вас завжди нове ядро, Python та компілятори з CUDA.
Якщо ви все таки наважитесь на збірку міні-сервера на базі P104-100, краще обирайте операційну систему яка повністю сумісна с CUDA 12.8-12.9.
Чому так? Що ж, кому дійсно цікаво, прошу:
На практиці "свіжість" Arch обернулася війною з оточенням: новітній системний GCC 14 відмовлявся дружити з nvcc, оновлена glibc 2.41 ламала стандартні заголовки CUDA через конфлікти rsqrt, змушуючи вручну пакувати патчі та заморожувати пакунки. Вибір фіксованого дистрибутива (на кшталт Ubuntu 22.04/24.04 LTS або Debian 12) одразу знімає цей головний біль: там версії системного GCC та glibc спочатку сертифіковані під стек CUDA 12.8–12.9, тож складання проєктів рівня llama.cpp чи stable-diffusion.cpp проходить штатно з коробки - без танців із піннінгом GCC 13 та редагуванням системних інклудів NVIDIA.
Але я "геній" якому подобається Арч, тому і був змушений пройти через це пекло. Вам це робити не обов'язково.
Моделі
LLM
Gemma 4 E4B (QAT, квант Q4_KM);
Gemma 4 26B A4B (QAT, квант IQ4_XS);
Qwen 3.5 9B (квант IQ4_XS);
Qwen 3.8 27B (квант UD-IQ4_XS).
Трошки поясню вибір моделей для тестування. Gemma 4 E4B - нова і дуже складна LLM, з приблизно 4,5 млрд "ефективних" параметрів при близько 8 млрд фізичних у VRAM (42 шари). Основна різниця полягає у Per-Layer Embeddings (PLE): кожен декодер-шар має власну велику таблицю ембедингів, але вона використовується лише як швидкий пошук за індексом токена, а не бере участі у повноцінних матричних обчисленнях, тому в "ефективний" бюджет обчислень її не рахують, хоча в пам'яті вона чесно лежить цілком, роблячи E4B ефективно з ~4,5B у ~8B загальних параметрів.
Таким чином, по "розуму", вона близька до Qwen 3.5 9B, що і є другим моїм вибором, оскільки він вельми непогано показує себе у повсякденному використанні.
Gemma 4 26B A4B - це взагалі "рай" для локального запуску на старому залізі. Бо це MoE модель: при загальному обсязі параметрів у 26 мільярдів, на кожному токені активується лише 4 мільярди. Це дозволяє Gemma 4 26B бути надзвичайно швидкою незалежно від наявності матричних блоків у GPU, ба більше - вона вельми непогано працює на сучасних не дуже потужних CPU.
Ну і фінально - Qwen 3.8 27B. Це новітніша та найпотужніша модель з відкритими вагами (open source), реліз якої відбувся зовсім нещодавно. За підсумками бенчмарків, вона доволі серйозно випереджає усі наявні локальні LLM. Але що важливіше, Qwen 3.8 27B це щільна (dense) модель. Тобто на кожен токен, вона має проганяти усі свої ваги через відеопам'ять графічного адаптера.
Diffusion
Krea 2 Turbo (DiT, квант Q3_K);
ANIMA (DiT, квант Q8);
Illustrious XL (файн-тюн SDXL, U-Net, квант Q8).
Тепер щодо дифузних моделей. Krea 2 - одна з найпотужніших моделей яку можна запустити локально. 12 мільярдів параметрів, текстовий енкодер - Qwen3-VL-4B, Qwen image VAE. У максимальній точності, тільки сама Krea 2 важить приблизно 23 ГБ, енкодер 8 ГБ і VAE ~256 МБ. Тобто щоб запустити повний обсяг вагів у точності FP16, вам потрібно більше 32 ГБ (з урахуванням робочого процесу дифузної долі - десь 35-36 ГБ).
Але це далеко не вирок. Ми без особливих проблем можемо запустити, та комфортно використовувати Krea 2 на одній P104-100, причому, без спліту обчислень з CPU, чи з другою картою.
Квант самої дифузної моделі - Q3_K. Не дивуйтесь і не лякайтеся: на Q3_K можна працювати і отримувати доволі серйозні результати (нижче будуть приклади). А от для текстового енкодера ліпше не спускатися нижче четвертого кванта, тож для Qwen3-VL-4B я обрав балансний Q4_KM. З VAE все набагато простіше - вона повинна бути тільки FP16.
 ⤢ ВІДКРИТИ
Що ми маємо у залишку: з прапорцем --offload-to-cpu (коли в кожен момент часу у VRAM завантажений суто один активний модуль нейромережі, а не все одразу):
сама Krea 2 — 5,13 ГБ (плюс робочий простір для генерації від 1 ГБ для 512x512 та приблизно 2.7 ГБ для 1920x1080);
енкодер Qwen3-VL-4B — 2,32 ГБ;
Qwen VAE — 256 МБ.
Таким чином, ми ніколи не впираємося в стелю 8 ГБ VRAM, адже карта обробляє модулі послідовно на повній швидкості GPU, не ділячи обчислення з повільним процесором.
Гадаю, з Illustrious XL та ANIMA питань виникнути не повинно: ці моделі без особливих проблем залітають у 8 ГБ навіть у FP16. Чому ж тоді були обрані саме кванти Q8?
По-перше, вони практично не відрізняються по якості від FP16, а важать при цьому удвічі менше. По-друге, якщо взяти лише одну карту, й забажати паралельно запустити на ній умовну Gemma 4 E4B у Q4_KM, що важить 3,92 ГБ (для редагування чи створення промптів) та ANIMA у Q8 з вагою 2,08 ГБ (для самої генерації зображень) - у вас банально не буде вибору, окрім як використовувати Q8 квант, щоб не піймати виліт через OOM (критичну нестачу відеопам'яті).
Методика тестування
Кожна модель на кожному прискорювачу проганялась по три рази через llama.cpp bench, або через самописний бенчмарк для stable-diffusion.cpp, після чого, обчислювався середній показник і вже він заносився у підсумкову таблицю.
Тестування
P104-100 проти GTX 1070
Для початку, я вирішив закрити одне вкрай важливе питання: чи є повноцінна GTX 1070 з активними 16 лініями PCIe швидшою за свою порізану майнінгову сестру P104-100.
 ⤢ ВІДКРИТИ
Налаштування:
Bash
  -dev CUDA0 \
  -fa on \
  -ctk f16 -ctv f16 \  # FP16 (за замовчуванням, можна і просто прибрати ці два флаги)
  -ctk q8_0 -ctv q8_0 \  # Q8 KV Cache
  -ctk q4_0 -ctv q4_0 \  # Q4 KV Cache
  -ngl 999 \
  -d 0,4096,8192,16384,24576,32768,49152,65536,98304,131072 \
  -p 512 -n 128 \
  -b 2048 -ub 512 \
Gemma 4 E4B QAT Q4_KM
Prompt Processing (PP) · t/s
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 814.2
Gemma 4 E4B QAT Q4_KM
Text Generation (TG)· t/s
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 44.2
 ⤢ ВІДКРИТИ
Krea 2 Turbo
Total generation time (seconds), 12 steps. Lower is better
512x512
768x768
1280x720
1216x832
1024x1024
1280x1280
1920x1080
GeForce GTX 1070P104-100
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 618.0
Результати кажуть самі за себе. Інференс Gemma 4 E4B фактично ідентичний на обох прискорювачах, а ось в генерації зображень через Krea 2 GTX 1070 виривається вперед. Тож як бачите, швидкість шини PCIe все ж впливає на продуктивність чипа GP104, але це 1-5%. Сенсу обирати під інференс ШІ-моделей повноцінну 1070 небагато. До того ж, я хочу підкреслити одну важливу деталь:
Krea 2 Turbo
Diffusion sampling generation time (seconds), 12 steps. Lower is better
1920x1080
P104-100GeForce GTX 1070
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 548.4
Якщо відокремити лише дифузну частку, то P104-100 виявляється швидшою за GTX 1070. Проте так, загалом, через урізану шину та жорсткий офлод кожного модуля нейромережі в ОЗП через горезвісну PCIe, P104-100 трішки поступається своїй повноцінній сестрі.
P104-100: Мовні ШІ-моделі (LLM)
Тепер перейдемо до більш детальних тестів. З огляду на те, що ми маємо справу з доволі старою архітектурою Pascal, я вирішив зробити дещо більше досліджень, особливо з різним квантуванням контекстного вікна. На перший погляд здається, що стиснення KV Cache з FP16 до умовного Q8 не повинно вплинути на швидкодію прискорювачів, але це не так. То ж перейдемо безпосередньо до аналізу продуктивності P104-100.
Gemma 4 E4B на одній P104-100
⤢ ВІДКРИТИНалаштування:
Bash
  -dev CUDA0 \
  -fa on \
  -ctk f16 -ctv f16 \  # FP16 (за замовчуванням, можна і просто прибрати ці два флаги)
  -ctk q8_0 -ctv q8_0 \  # Q8 KV Cache
  -ctk q4_0 -ctv q4_0 \  # Q4 KV Cache
  -ngl 999 \
  -d 0,4096,8192,16384,24576,32768,49152,65536,98304,131072 \
  -p 512 -n 128 \
  -b 2048 -ub 512 \
Gemma 4 E4B QAT Q4_KM | P104-100 (Single GPU)
Prompt Processing (PP), t/s
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 798.8
Gemma 4 E4B QAT Q4_KM | P104-100 (Single GPU)
Text Generation (TG), t/s
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 43.9
По-перше треба зазначити, що одна P104-100 доволі непогано показує себе у зв'язці з актуальною моделлю Gemma 4 E4B: якщо не квантувати контекст і використовувати повну точність FP16, та не вилазити за 65к токенів, продуктивність сягає доволі комфортних від 800 до 150 т/с на обробці вхідного промпта, та від 43 до 29 т/с на вихідній генерації.
А от якщо ви забажаєте стиснути контекст до Q8-Q4, наприклад, для того щоб паралельно вмістити у відеопам'ять умовну SDXL, або ANIMA, то вам доведеться миритися зі значною втратою швидкості. Обробка вхідного промпта не особливо страждає, з цим ще можна миритися. Проте падіння генерації з 30 до 18 т/с на довжині в 65к контексту - це вже буквально трагедія.
Одразу тут - на прикладі Gemma 4 E4B, я спробую описати головну ахіллесову п'яту NVIDIA Pascal, щоб далі вже до цього не повертатися: сенсу розганяти відеопам'ять немає. На жаль, вузьким місцем прискорювача P104-100 є саме швидкодія GPU. Це можна було прослідкувати ще при тесті GTX 1070 проти P104-100: ПСП першої 256 ГБ/с, тоді як у нашої піддослідної цілих 320 ГБ/с. Таким чином, пришвидшити наш майнінговий обрубок можна лише за допомогою розгону графічного процесора, а як ми з вами вже з'ясували, йому і так може бути нелегко.
Тобто суттєве зниження продуктивності не виправити розгоном VRAM. В цьому банально немає практичного сенсу. Безумовно, не усі моделі так жорстко реагують на стиснення KV Cache з FP16 до Q8-Q4. Але фактично падіння продуктивності від квантування контекстного вікна уникнути неможливо.
Gemma 4 E4B на двох P104-100
⤢ ВІДКРИТИНалаштування:
Bash
  -dev CUDA0/CUDA1 \ - активны два GPU
  -sm layer -ts 1/1 \ - формат розділення вагів та відсоток шарів моделі у кожній карті
  -fa on \
  -ctk f16 -ctv f16 \  # FP16 (за замовчуванням, можна і просто прибрати ці два флаги)
  -ctk q8_0 -ctv q8_0 \  # Q8 KV Cache
  -ctk q4_0 -ctv q4_0 \  # Q4 KV Cache
  -ngl 999 \
  -d 0,4096,8192,16384,24576,32768,49152,65536,98304,131072 \
  -p 512 -n 128 \
  -b 2048 -ub 512 \
Gemma 4 E4B QAT Q4_KM | P104-100 (Dual GPU)
Prompt Processing (PP), t/s
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 969.8
Додавання другого прискорювача дає вельми непоганий буст до обробки вхідного тексту. Ба більше, навіть на 128к контексту ми маємо 20% приріст швидкодії з 84 до 108 т/с. Звичайно, 100 т/с на обробку це доволі довго, особливо, якщо ви маєте справу з вайбкодингом та великим проєктом, але це все ще доволі непоганий результат.
Gemma 4 E4B QAT Q4_KM | P104-100 (Dual GPU)
Text Generation (TG), t/s
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 43.0
Чого не скажеш про генерацію: швидкість видачі вихідних токенів буквально не змінюється від додавання другої P104-100. І це вельми прогнозований результат, адже перлеер спліт на старих картах фактично і не повинен давати ніякого зростання швидкодії.
Qwen 3.5 9B на двох P104-100
 ⤢ ВІДКРИТИ
Що ж, тепер перейдемо до тестів мовних моделей тільки на двох GPU. Не переймаєтесь, трішки нижче ще будуть тести на одній карті.
Bash
  -dev CUDA0/CUDA1 \ - # активны два GPU
  -sm layer
  -ts 1/1 \ - # формат розділення вагів та відсоток шарів моделі у кожній карті
  -fa on \
  -ctk f16 -ctv f16 \  # FP16 (за замовчуванням, можна і просто прибрати ці два флаги)
  -ctk q8_0 -ctv q8_0 \  # Q8 KV Cache
  -ctk q4_0 -ctv q4_0 \  # Q4 KV Cache
  -ngl 999 \
  -d 0,4096,8192,16384,24576,32768,49152,65536,98304,131072 \
  -p 512 -n 128 \
  -b 2048 -ub 512 \
Qwen 3.5 9B IQ4_XS | P104-100 (Dual GPU)
Prompt Processing (PP), t/s
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 831.6
Qwen 3.5 9B зовсім інакше реагує на стиснення контексту. Prompt Processing виявився найповільнішим саме на FP16 точності. Але це відчувається лише на старті сесії - буквально на 1000-2000 токенів контекстного вікна. Далі усі кванти йдуть рівно, обробляючи від 700 на старті, до 140 токенів на секунду при завантаженні 128к. Це вражаючий результат.
Qwen 3.5 9B IQ4_XS | P104-100 (Dual GPU)
Text Generation (TG), t/s
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 36.9
Проте швидкість генерації відповіді знову суттєво падає від кантування KV Cache. Причому, подивіться на результати Q4. Якщо Gemma фактично ніяк не реагувала на стрибок з Q8 до Q4, то Qwen буквально валиться, і після 8к контексту це виглядає доволі похмуро.
Проте, слід зазначити, що за фактом це не проблема. Адже дві P104-100 ідеально тримають 128к контексту навіть у FP16.
Gemma 4 26B A4B на двох P104-100
 ⤢ ВІДКРИТИ
От і прийшов час реально сильних моделей. Gemma 4 26B A4B, це буквально рятівне коло, бо вона має непогану базу знань, і активує на токен лише 4 мільярди параметрів, що робить її дуже швидкою. Наскільки? Давайте з'ясуємо.
Markdown
  -dev CUDA0/CUDA1 \ - активны два GPU
  -sm layer
  -ts 1/1 \ - формат розділення вагів та відсоток шарів моделі у кожній карті
  -fa on \
  -ctk f16 -ctv f16 \  # FP16 (за замовчуванням, можна і просто прибрати ці два флаги)
  -ctk q8_0 -ctv q8_0 \  # Q8 KV Cache
  -ctk q4_0 -ctv q4_0 \  # Q4 KV Cache
  -ngl 999 \
  -d 0,4096,8192,16384,24576,32768,49152,65536,98304,131072 \
  -p 512 -n 128 \
  -b 2048 -ub 512 \
Gemma 4 26B A4B IQ4_XS | P104-100 (Dual GPU)
Prompt Processing (PP), t/s
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 585.8
Одразу поясню, чому графіки FP16 та Q8 обриваються на 32 і 65к контексту відповідно: банальна нестача відеопам'яті. Тобто ви не зможете запустити цю модель з якісними квантами KV Cache на 96 або 128к. Для цього вам вже буде потрібна третя карта P104-100.
Тепер щодо результатів тестування. Інпут токенів не вражає: всього лише 579 на старті контекстного вікна і доволі повільні 72 т/с на при-кінці. Комфортною стелею я б назвав 32к контексту, але це лише моя думка.
Gemma 4 26B A4B IQ4_XS | P104-100 (Dual GPU)
Text Generation (TG), t/s
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 50.8
А тепер подивіться на вихідну генерацію токенів! 50 на старті і 38 т/с при заповненні 32к контекстного вікна! Це неймовірний результат! Причому, давайте будемо відверті, навіть на Q4 контексті швидкість доволі серйозна (від 43 до 14 т/с), і впевнено перевершує ті показники, що ми отримали на крихітній Gemma 4 E4B!
Тобто, на двох P104-100, які коштують лише по 15 баксів за карту, ми маємо вельми розумну та надшвидку модель, яка дійсно може робити складні завдання, та писати непоганий код!
Qwen 3.8 27B
 ⤢ ВІДКРИТИ
Остання по списку, але не по значенню. Qwen 3.8 27B - щільна модель. Тобто на кожен токен вона активує усі свої 27 мільярдів параметрів. Що за фактом робить її надскладною у використанні навіть на потужних GPU.
Налаштування бенчмарку:
Markdown
  -dev CUDA0/CUDA1 \
  -sm layer -ts 0.55/0.45 \
  -mg 0\
  -fa on \
  -ctk f16 -ctv f16 \  # FP16 (за замовчуванням, можна і просто прибрати ці два флаги)
  -ctk q8_0 -ctv q8_0 \  # Q8 KV Cache
  -ctk q4_0 -ctv q4_0 \  # Q4 KV Cache
  -fa on \
  -ngl 999 \
  -d 0,4096,8192,16384,24576,32768,49152,65536 \
  -p 512 -n 128 \
  -b 2048 -ub 512 \
Одразу поясню технічний нюанс щодо розподілу пам'яті через аргумент -ts 0.55/0.45 (--tensor-split). На відміну від Gemma 3 26B A4B, де шари розподіляються симетрично, модель Qwen 3.8 27B категорично відмовляється ділитися порівну між двома 8-гігабайтними відеокартами через відчутний оверхед базових модулів нейромережі. Зокрема, перший (другий фізично) графічний адаптер бере на себе додаткове навантаження у вигляді первинного ембедінгу токенів, вихідного шару нормалізації та фінальної матриці виведення логітів (LM head). Якщо ви залишите дефолтний поділ 1:1 (-ts 1,1), обчислювальний буфер першої карти заб'ється значно раніше за нульову, що гарантовано спричинить OOM (Out of Memory) задовго до наближення до ліміту контексту. Тільки завдяки ручному зміщенню пропорції виділення VRAM до 55% на головну карту та 45% на другу вдається збалансувати залишки вільної відеопам'яті під динамічний KV Cache та розтягнути контекстне вікно аж до 32k токенів.
⤢ ВІДКРИТИQwen 3.8 27B IQ4_XS | P104-100 (Dual GPU)
Prompt Processing (PP), t/s
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 225.1
Вже при обчислюванні промпту видно, що швидкодія двох P104-100 знаходиться на вкрай низькому рівні: лише 222 т/с на старті і жахливі 75 т/с на 65к контексту. Причому, як бачите, Qwen 3.8 27B важить настільки багато, що фактично унеможливлює імовірність використати 96к, або, тим паче, 128к контекстного вікна навіть у кванті Q4.
Qwen 3.8 27B IQ4_XS | P104-100 (Dual GPU)
Text Generation (TG), t/s
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 11.1
Генерація відповідей не менш сумна: 11 токенів на секунду,темп яких хоч і не так стрімко як у попередніх моделей, але знижується до 9 т/с при FP16, та аж до 5 т/с при Q4.
Давайте так: загалом зв'язку Qwen 3.8 27B з двома P104-100 можна використовувати, але тільки в тому випадку, якщо ви непримхливий користувач або якщо ви нікуди не поспішаєте. Проте за фактом це дуже повільно.
P104-100 проти RTX 2060 SUPER
В наступному розділі ми розглянемо варіант, коли у вас вже є якась відносно сучасна відеокарта (в моєму випадку це GeForce RTX 2060 SUPER) - яка має тензорні ядра, та повну архітектурну підтримку точності FP16 і обмірковуєте можливість додавання до неї P104-100. Але для початку, давайте подивимось наскільки RTX 2060 SUPER швидша за P104-100.
Gemma 4 E4B
⤢ ВІДКРИТИGemma 4 E4B QAT Q4_KM | P104-100 vs RTX 2060 SUPER
Prompt Processing (PP), FP16 KV Cache, t/s
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 2.2k
Якщо на початку контекстного вікна RTX 2060 SUPER демонструє "лише" 162% перевагу у обчисленні вхідних токенів, то на глибині 128 тисяч контексту цей показник сягає приголомшливих 680%. Це доволі значний відрив. Тензорні ядра дійсно значно прискорюють обробку промпта.
Gemma 4 E4B QAT Q4_KM | P104-100 vs RTX 2060 SUPER
Text Generation (TG), FP16 KV Cache, t/s
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 81.3
З іншого боку, вихідні токени, або ж "генерація" дається RTX 2060 SUPER не настільки вдало: лише двократна перевага над P104-100. Тепер давайте
Krea 2 Turbo
⤢ ВІДКРИТИKrea 2 Turbo
Total generation time (seconds), 12 steps. Lower is better
512x512
768x768
1280x720
1216x832
1024x1024
1280x1280
1920x1080
GeForce RTX 2060 SUPERP104-100
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 618
У випадку генерації зображень через Krea 2 Turbo, різниця між картами зростає не зовсім пропорційно. На роздільній здатності 512х512, 2060 SUPER швидша за P104-100 лише на 78%. Але як тільки ми підвищуємо розмір до 768х768, Turing обходить Pascal вже на 117%, а у 1080p перевага сягає 167%.
Тож як бачите, загалом, GeForce RTX 2060 SUPER доволі відчутно обходить P104-100, а значить, і GTX 1070. Ця ситуація декого може трішки заплутати. Адже чому так? У багатьох іграх вони не так далеко знаходяться одна від одної. Але тут все доволі банально: Turing має повну підтримку формату точності FP16 (подвійна швидкість відносно FP32), у той час як Pascal при необхідності використання FP16 фолбечить (робить відкат) на FP32, тому що швидкість його FP16 - це лише 1:64 від швидкості FP32.
P104-100 + RTX 2060 SUPER: Мовні ШІ-моделі (LLM)
Тепер подивимось наскільки RTX 2060 SUPER пришвидшить P104-100: чи є сенс додавати бюджетний майнерський прискорювач до повноцінної відеокарти.
Gemma 4 26B A4B
⤢ ВІДКРИТИНалаштування бенчмарку:
Markdown
  -dev CUDA0/CUDA1 \
  -sm layer \
  -ts 1/1 \
  -mg 0 \
  -fa on \
  -ngl 999 \
  -d 0,4096,8192,16384,24576,32768 \
  -p 512 -n 128 \
  -b 2048 -ub 512 \
Gemma 4 26B A4B IQ4_XS | P104-100 + RTX 2060 SUPER
Prompt Processing (PP), FP16 KV Cache, t/s
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 719.7
Що ж, додавання до більш-менш актуальної відеокарти 2060 SUPER одного прискорювача P104-100 дає доволі відчутний приріст у 22% продуктивності в обчисленні контексту, відносно двох P104-100.
Gemma 4 26B A4B IQ4_XS | P104-100 + RTX 2060 SUPER
Text Generation (TG), FP16 KV Cache, t/s
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 59.3
Генерація токенів на P104-100 + RTX 2060 SUPER збільшується з 50 до 58 т/с, що дає 16% переваги над двома P104-100. Це теж непоганий приріст, хоч і не такий разючий як при обчисленні контексту.
Qwen 3.8 27B
⤢ ВІДКРИТИНалаштування бенчмарку:
Markdown
  -dev CUDA0/CUDA1 \
  -sm layer \
  -ts 0.55/0.45 \
  -mg 0\
  -fa on \
  -ngl 999 \
  -d 0,4096,8192,16384,24576,32768,49152,65536 \
  -p 512 -n 128 \
  -b 2048 -ub 128 \
Qwen 3.8 27B IQ4_XS | P104-100 + RTX 2060 SUPER
Prompt Processing (PP), FP16 KV Cache, t/s
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 321.4
При заміні другої P104 на RTX 2060 SUPER ми отримуємо 42% пришвидшення обробки вхідних токенів, що вельми непогано.
Qwen 3.8 27B IQ4_XS | P104-100 + RTX 2060 SUPER
Text Generation (TG), FP16 KV Cache, t/s
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 13.9
Вихідна генерація знов не вражає: заміна одного з старих прискорювачів на більш швидший дає лише 25%, що зовсім не рятує, адже замість 11 ми отримали 14 т/с. Це все ще дуже повільно.
Таким чином, сучасна карта не просто "може" працювати зі старим адаптером, вона навіть дає вельми значний буст до продуктивності. Звісно, за умови того, що ви вкажете llama.cpp, хто саме "головний" адаптер у вашій зв'язці через прапорець "-mg 0" (0 - це порядковий номер вашого графічного адаптера, якщо "потужніша" карта стоїть у другому слоті, її номер може бути 1 чи 2 - використайте в консолі "nvidia-smi" щоб дізнатися детальніше за яким числом закріплена ваша відеокарта).
P104-100 проти Radeon RX 470 8GB
Неочікуване протистояння, правда? Зараз поясню: майнінгова версія RX 470 коштує приблизно на 10-20% дорожче за P104-100, тому що в багатьох випадках, червона карта має фізичний роз'єм DVI-D та повноцінну шину PCIe-3.0 x16. Тобто так, її можна використовувати як звичайну відеокарту. Але нас це фактично не хвилює. Зараз ера Vulkan, що дає змогу будь яким відеокартам, навіть без CUDA запускати нейромережі. Тож давайте з'ясуємо, чи зможе трішки дорожча RX 470 на вулкані протистояти P104-100 яка працює на CUDA.
Gemma 4 E4B
⤢ ВІДКРИТИGemma 4 E4B QAT Q4_KM | P104-100 vs RX 470 8GB
Prompt Processing (PP), FP16 KV Cache, t/s
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 798.8
Обробка вхідного тексту це очевидно не сильна сторона RX 470. Різниця між прискорювачами становить більше двох раз - 797 проти 336 т/с на старті і до до приголомшливих чотирьох разів на прикінці контекстного вікна. Тобто, P104-100 швидша за червоного візаві від 134% до 366%. Але як ми пам'ятаємо, обробка промпта це ще не все.
Gemma 4 E4B QAT Q4_KM | P104-100 vs RX 470 8GB
Text Generation (TG), FP16 KV Cache, t/s
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 43.9
Різниця в генерації відповідей нейромережі вже не така разюча. P104-100 виривається вперед лише 10% на початку та 120% на відмітці в 128к контекстного вікна. Тобто так, P104 все ще відчутно перевершує RX 470, але це вже не так вражає, як було у обробці тексту. І загалом, прискорювач від AMD все таки можна використовувати для роботи з Gemma 4 E4B.
Krea 2 Turbo
⤢ ВІДКРИТИKrea 2 Turbo | P104-100 vs RX 470 8GB
Total generation time (seconds), 12 steps. Lower is better
512x512
768x768
1280x720
1216x832
1024x1024
1280x1280
1920x1080
P104-100 | CUDARX 470 8GB | Vulkan
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 1.3k
Щодо генерації зображень в Krea 2, то тут все доволі лінійно: приблизно двократна різниця між P104-100 та RX470 з очевидним лідерством першого прискорювача. Але погодьтесь, це все одно дивовижно, адже червона карта не має ні своєї екосистеми, ні підтримки умовної інструкції DP4a, проте здатна видавати ту саму якість зображення що й P104-100 на CUDA:
Важливо зазначити: модель, кроки, та сід були ідентичні. Різниця в зображеннях полягає у тому, що бекенди (CUDA та VULKAN) - трошки інакше працюють з моделями.
Дві P104-100 проти GeForce RTX 3090
Ось ми і дісталися до найбожевільнішої частини цього матеріалу. В реальності, сенсу в цьому протистоянні не дуже багато, але все одно, доволі цікаво, наскільки одна топова в минулому відеокарта зможе перевершити два майнінгових прискорювача. До того ж, я гадаю, що тут все ж буде доволі корисна інформація, але усьому свій час.
Gemma 4 26B A4B
⤢ ВІДКРИТИGemma 4 26B A4B IQ4_XS | 2 x P104-100 vs RTX 3090
Prompt Processing (PP), FP16 KV Cache, t/s
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 4.7k
Gemma 4 26B A4B IQ4_XS | 2 x P104-100 vs RTX 3090
Text Generation (TG), FP16 KV Cache, t/s
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 167.4
Як бачите по графіку, у тестового стенду є велика проблема з відеокартою GeForce RTX 3090. Чип Core i5-4670K виявився недостатнім щоб задовольнити потреби GPU GA102 в обробці промпту. Тобто, якщо ви маєте щось швидше за лінійку RTX 2000, вам краще дивитися на більш потужні CPU з підтримкою DDR4. Але як я вже говорив у розділі "Тестовий стенд", я свідомо обрав найдешевший варіант, щоб показати в реальному використанні - стара платформа з двоканальною DDR3 та 4-ядерним чипом не стане на заваді продуктивності серії NVIDIA P100.
Тепер щодо результатів тесту: по-перше, 3090 в змозі тримати 128к контексту без стиснення у точності FP16, що з огляду 24 ГБ GDDR6X - вельми очевидно. Але навіть вона доволі серйозно втрачає в продуктивності на краю контекстного вікна. По-друге, різниця між двома P104-100 та RTX 3090 - катастрофічна і сягає 1023% в обробці промпта, та 230% у генерації.
Qwen 3.8 27B
⤢ ВІДКРИТИQwen 3.8 27B IQ4_XS | 2x P104-100 vs RTX 3090
Prompt Processing (PP), FP16 KV Cache, t/s
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 1.4k
Qwen 3.8 27B IQ4_XS | 2x P104-100 vs RTX 3090
Text Generation (TG), FP16 KV Cache, t/s
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 45.8
Новітня Qwen 3.8 27B демонструє ще більш гнітючу картину, адже навіть RTX 3090 не в змозі дозволити своєму власнику встановити якість контекстного вікна на FP16 при глибині у 128к, змушуючи обмежитесь лише 64к.
Проте, якщо не брати до уваги розмір контексту, Чип GA102 у парі зі швидкісною GDDR6X забезпечують максимально гідний TPS (tokens per second) на цій моделі. Близько 1300 т/с на вхід, та 45 т/с на вихід можна вважати цілком придатними для повсякденного використання не тільки у чаті, а й для важкого кодування.
Якщо ж порівнювати з нашими двома P104-100, то різниця між колись топовою 3090 та майнінговими "обрізками" становить 640% та 309% в обробці та генерації токенів відповідно. Звісно, на користь RTX прискорювача.
Krea 2 Turbo
⤢ ВІДКРИТИKrea 2 Turbo | P104-100 vs RTX 3090
Total generation time (seconds), 12 steps. Lower is better
512x512
768x768
1280x720
1216x832
1024x1024
1280x1280
1920x1080
RTX 3090P104-100
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 618
Тут навіть слова зайві: 3090 чавить P104-100 без шансів. Причому, як можна помітити по графіку, зі збільшенням роздільної здатності RTX прискорювач доволі повільно втрачає швидкість, в той час як P104 уповільнюється ледь не в два рази після суттєвої зміни розміру зображення.
P104-100: Дифузійні моделі (Image Generation)
Цей розділ - скоріш бонусний, адже будемо відверті: якщо P104-100 в змозі запустити Krea 2, то файн-тюн SDXL та крихітна ANIMA для неї будуть відносно легкою прогулянкою. Тим не менш, я вважаю, що ці результати для когось можуть стати вирішальними.
ANIMA 2B
 ⤢ ВІДКРИТИ
Одразу позначу важливу деталь: я не використовував для тесту моделі ANIMA адаптер "Turbo LORa", адже це лабораторне дослідження. З нею ви зможете скоротити час генерації від двох до чотирьох разів (з 25 кроків до 6-12 в залежності від версії файн-тюну). Проте пам'ятайте: якість фінального зображення при виконанні генерації разом з адаптером буде нижча (LORa душить різноманіття основної моделі, що впливає на деталізацію).
ANIMA 2B
Total generation time (seconds), 25 steps. Lower is better
512 x 51238
768 x 76893
1280 x 720165
1216 x 832180
1024 x 1024191
1280 x 1280349
1920 x 1080497
P104-100
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 497
Illustrious XL 2.6B (3.5B AiO)
 ⤢ ВІДКРИТИ
Illustrious XL 2.6B (3.5B AiO)
Total generation time (seconds), 25 steps. Lower is better
512 x 51226
768 x 76852
1280 x 72088
1216 x 83291
1024 x 102495
1280 x 1280157
1920 x 1080207
Series 1
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 207
Krea 2 Turbo 12B
⤢ ВІДКРИТИKrea 2 Turbo
Total generation time (seconds), 12 steps. Lower is better
512x51275
768x768152
1280x720241
1216x832259
1024x1024280
1280x1280468
1920x1080618
Series 1
// ДЖЕРЕЛО · UMTALE LAB BENCHMAX 618
Чи реально генерувати зображення на P104-100? Безумовно. Єдине, що я вам пораджу, так це спочатку робити прохід на відносно низькій роздільній здатності (наприклад 512х1024) і вже потім використовувати метод img2img через саму діффузну модель, або через простенькі апскейлери.
Відверто кажучи, я був вражений фактом, що до прикладу, умовна Krea 2 дійсно видає непогані результати при квантуванні вагів у Q3_K. Так, я розумію, що звучить це максимально здичавіло. Але це факт, який я вам демонстрував декілька разів за цей матеріал.
Підсумки
На жаль, вам не здалося, ця стаття реально вийшла дещо зім'ятою. Дослідження продуктивності стареньких майнінг-прискорювачів P104-100 виявилось не таким простим та вичавило з мене багацько часу:
Вибір моделей, тести на придатність, дослідження впливу параметрів на швидкість генерації, тощо. Як приклад, ще на етапі підбору моделей з пула відсіявся Qwen 3.6 35B A3B, тому що обирати квант нижче ніж IQ4 я не бажав, а цей квант банально не поміщався у відеопам'ять двох P104-100. Сумно? Звісно ж! Бо попри загальний розмір моделі у 35 мільярдів параметрів, на токен вона активує лише 3 мільярди. Тож так, Qwen 3.6 35B A3B був би швидший, та порівняно потужніший за Gemma 4 26B A4B. Але маємо що маємо.
Тепер щодо самих P104-100. На одному прискорювачі ви зможете без проблем запускати та працювати з вельми сильною моделлю Gemma 4 E4B. Я сам доволі часто її використовую, особливо для редактури промптів та виявлення помилок. Окрім цього, P104-100 доволі непогано генерує зображення. Безумовно, швидкість відносно актуальних графічних адаптерів не вражає, але за свою ціну - це буквально подарунок. Бо копійчаний прискорювач ніколи не попросить у вас підписки, не згенерує у кутку картинки водяний знак, і, що важливіше, не буде обмежувати вас у фантазії.
На двох P104-100 вам відкривається світ реально гідних моделей. Gemma 26B A4B - це потужний інструмент, який в змозі допомогти в 75-80% ваших завдань. Звісно, вона не замінить вам Claude Fable 5, GPT 6 Astra або Gemini 3.8 Flash, проте вона й не створювалась для цього. Якщо вам буде цікаво, і під цим матеріалом буде багато реакцій, я зроблю окреме дослідження Gemma 26B A4B в розрізі реальних завдань і розповім, чи можна за допомогою цієї моделі написати повноцінний проєкт від початку до кінця.
Проте, пробачте мене, але я знову за своє: P104-100 - ДУЖЕ старі прискорювачі, та ще й після майнінгу. Тому будьте максимально обережні, якщо все таки наважитесь придбати їх. Плюс, це не ті адаптери, що "вставив і забув". Вам буде потрібен Linux та відносно багато часу, щоб налаштувати свій міні-сервер.
Тобто якщо казати відверто, P104-100 - це компроміс, на який дехто піде, навіть з урахуванням багатьох ризиків, а інші просто забудуть про існування цих прискорювачів. І обидва табори матимуть рацію.
Що ж, їжу для мізків я вам надав, а зараз маю ще дещо протестувати. В одному з наступних матеріалів на вас буде чекати топовий майнерський прискорювач на архітектурі Pascal та чипі GP102. А який буде це адаптер - здогадаєтесь самі, або просто дочекайтесь нової публікації.